端侧 AI 到底是什么?和云端大模型有什么不同
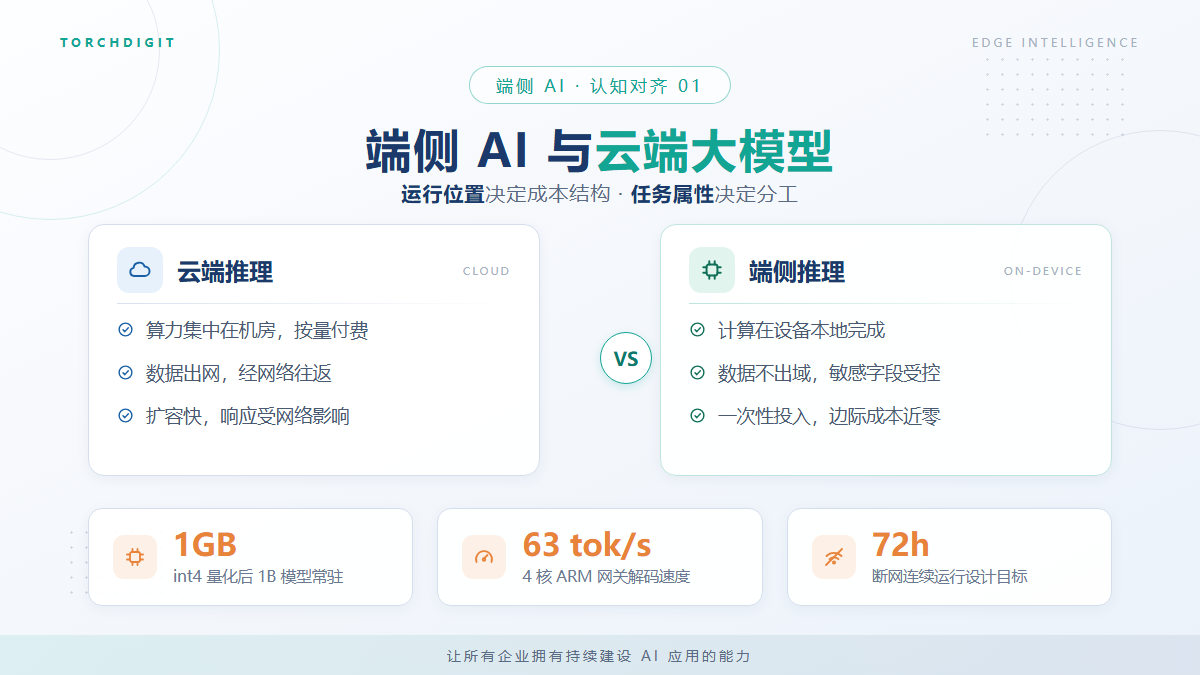
端侧 AI 不是把云端模型搬到本地,而是换了一套约束条件。同一件事——让模型回答问题——放在云端机房里和放在一台工控网关上,决定成败的变量完全不同。前者比的是集群规模与调度效率,后者比的是内存、功耗,以及断网之后还能不能干活。把这个差别看清楚,才能判断哪些任务该留在本地。
模型跑在哪,成本结构就不同
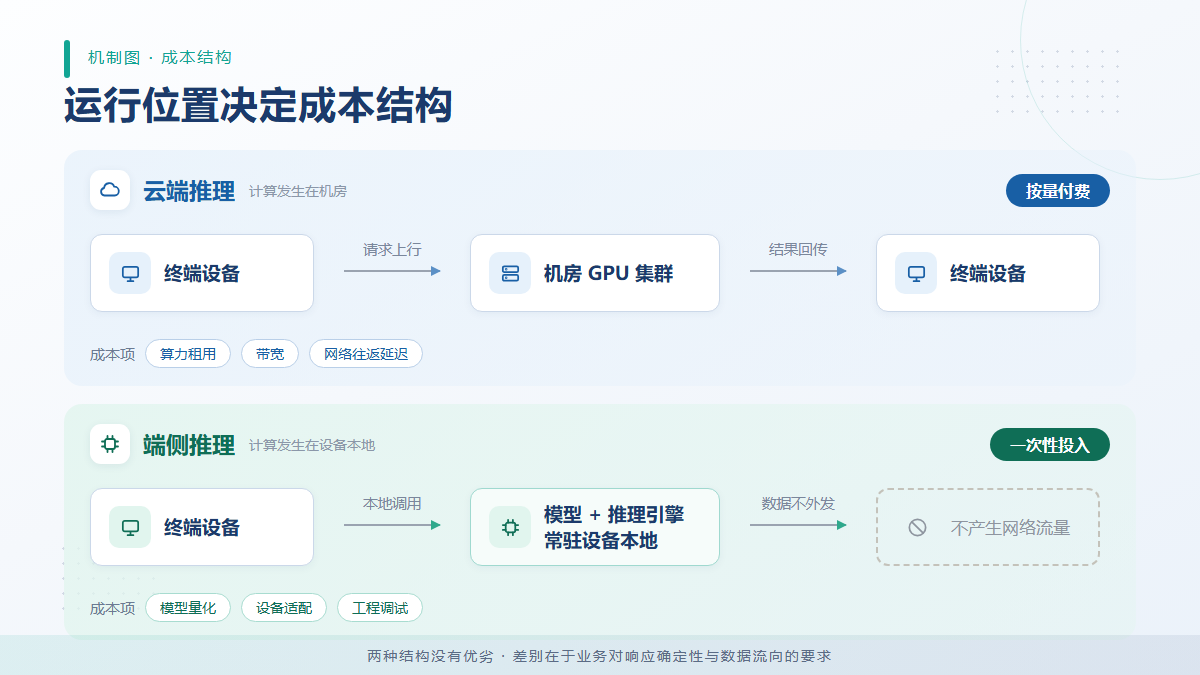
云端推理的账算在服务器上。一次请求从终端发出,经网络到达机房,GPU 集群完成计算,结果再回传。这条链路的成本集中在三处:算力租用、带宽、以及网络往返带来的延迟。企业按月付费,用多少算多少,扩容快,但对单次请求的响应时间没有控制权——排队和抖动都由服务端决定。
端侧推理把计算放回设备本身。模型文件随设备分发,运行时不再产生网络流量。成本结构因此前移:模型量化、设备适配、工程调试是一次性投入,设备装好之后,每次推理的增量成本接近于零。代价是这部分工程工作必须由自己承担。
两种结构没有优劣之分,差别在于业务对两件事的要求有多硬:响应时间是否必须确定,数据是否允许出网。
端侧的三条硬边界
把模型放进设备,会立刻撞上三个约束。
内存:端侧模型的权重需要常驻,不是运行时临时加载。按 int4 量化计算,1B 参数模型的权重大约占用 0.5GB 显存,加上运行时开销与上下文缓存,整体常驻内存落在 1GB 量级。这个数字决定了它能落在哪些设备上——消费级笔记本、工控网关、政务一体机都在射程之内,内存更紧的可穿戴设备则需要更小的规格。
算力:多数端侧设备没有独立 GPU。推理引擎必须能在 CPU 与 NPU 上把速度做出来。以 4 核 ARM 架构的无风扇工业网关为例,把 1B 模型的解码速度做到 63 tok/s,才够支撑交互式使用;低于这个量级,用户会明显感到等待。
网络:端侧方案的价值恰恰在断网时才体现出来。厂区网络抖动、专网物理隔绝、外场作业,这些场景下云端方案直接不可用。因此端侧方案需要按断网 72 小时连续运行的可靠性来设计,包括任务排队、本地缓存与恢复后的状态同步。
三条边界互相牵制:想跑更大的模型,内存就不够;想省电降低频率,速度就掉下来;想频繁同步数据,断网可用性就打折。端侧工程的核心工作,就是在这三者之间找一个能长期稳定运行的平衡点。
不是替代关系,是分工
端侧与云端更接近分工,而不是替代。
适合留在本地的是高频、低延迟、且输入数据敏感的任务:设备告警诊断、单据字段抽取、现场巡检纪要整理。这类任务的共同点是对响应时间敏感,且送入模型的内容往往包含不适合外发的信息。
适合继续放在云端的是需要大范围知识更新、复杂推理或跨系统整合的任务:行业报告生成、多源数据关联分析。这里有一个必须承认的前提——端侧模型的知识截止于它发布的那一刻,无法自行获取新信息。把时效性要求高的问答放到端侧,结果不会比放云端更好。
实际部署中更常见的形态是两者组合:端侧承担感知与初步判断,把需要更大算力的部分交给云端,敏感字段在本地完成脱敏之后再出网。这样既保住了响应速度,也守住了数据边界。
