企业上 AI 为什么第一步该想清楚数据在哪
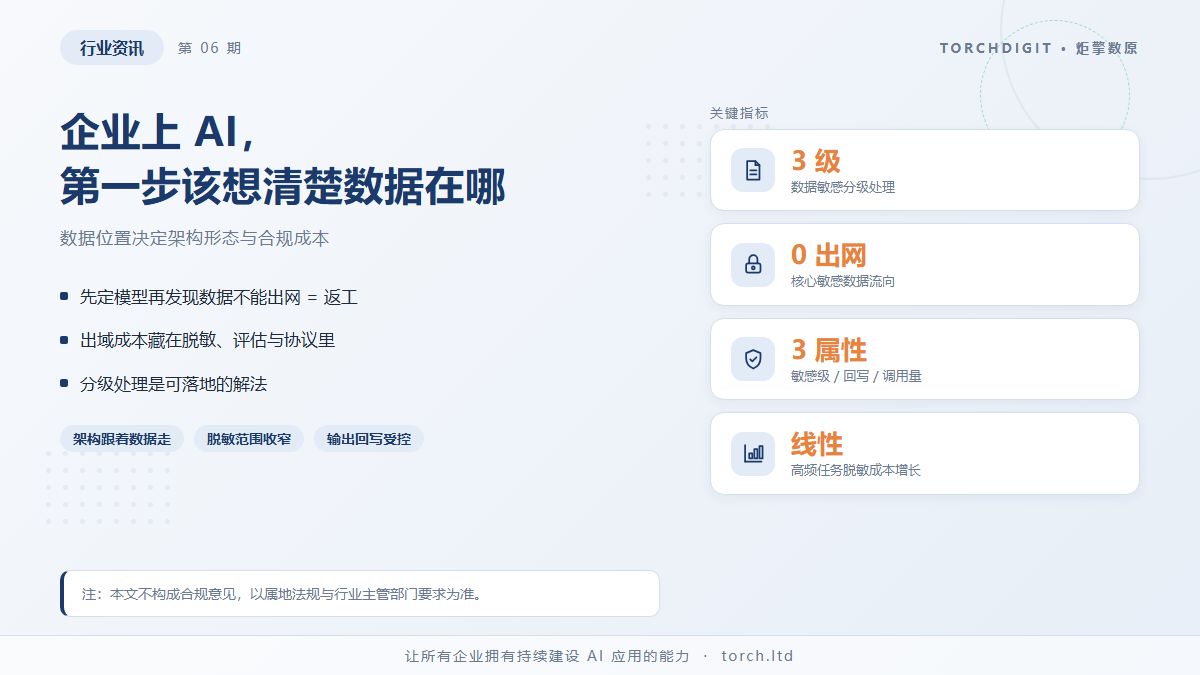
企业落地 AI,多数讨论集中在「用什么模型」,但更早该回答的问题是「数据在哪、能不能动」。数据的位置和流动方式,决定了架构的形态、合规的成本,甚至决定了哪些任务根本可以做。这一步想清楚了,后面的选型才不会返工。
数据位置决定架构形态
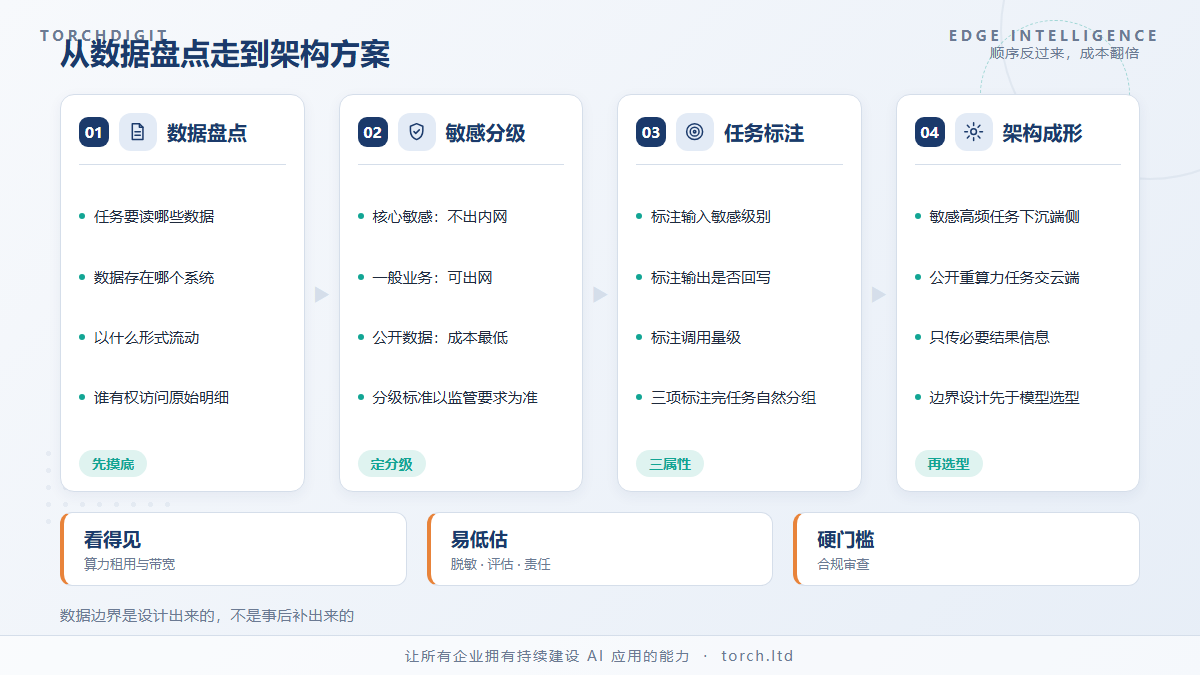
先做一次数据盘点:任务要读的数据存在哪里、以什么形式流动。原始数据集中在内网业务系统里,模型就必须能靠近它——要么推理进内网,要么数据出网,二选一。数据本身来自公开渠道或不涉敏感信息的任务,选择空间就大得多。
常见的返工路径是反着来:先定了云端方案,跑到合规审查才发现核心数据不能出内网,整个链路推倒重来。架构跟着数据走,不是数据迁就架构。
出域成本往往被低估
数据出网不是「传出去」一个动作,而是一串配套:字段级脱敏、传输加密、出境或出域合规评估、供应商数据处理协议、泄露责任划分。每一条都是工程量与法务量。
对高频任务,脱敏的边际成本尤其明显——每条数据都要过一遍处理流程,人工复核与系统建设成本随调用量线性增长。把这部分成本算进去再比较端云方案,结论常常和只看算力账单时不同。
分级是可操作的解法
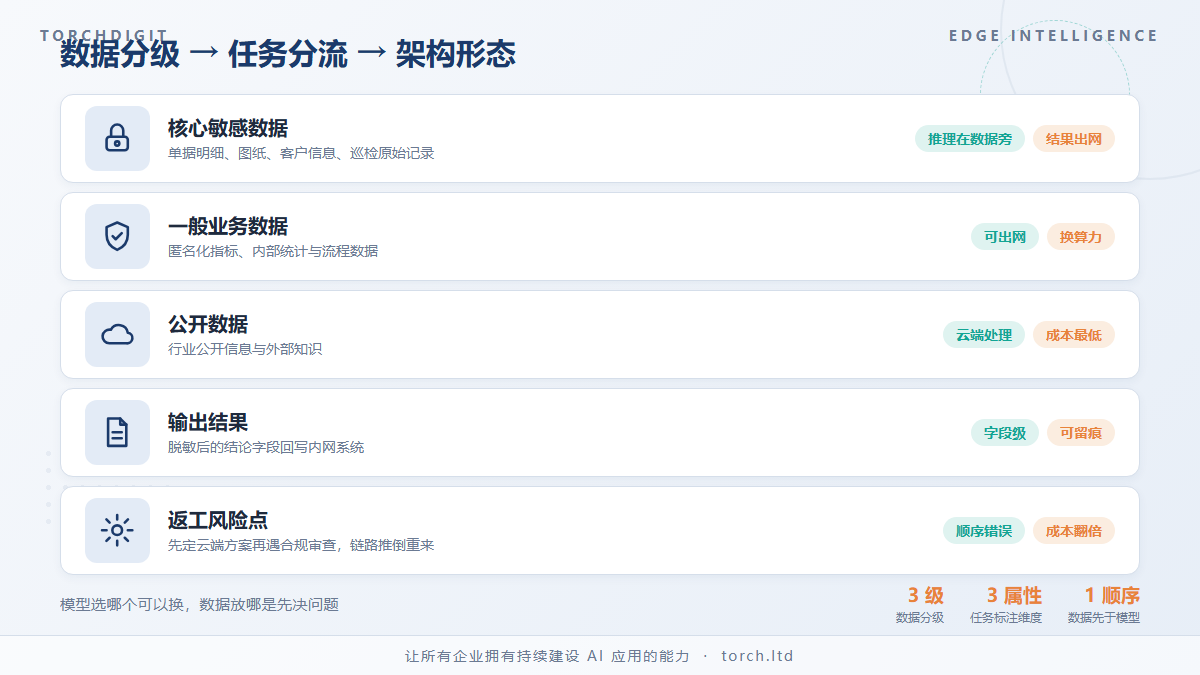
想清楚数据在哪之后,可行做法是分级处理。核心敏感数据留在内网,推理放在数据旁边,结果出网前只保留脱敏后的结论字段;一般业务数据可以出网,走云端获得更大算力与知识更新;公开数据随便用,成本最低。
分级的关键动作是给每个任务标注三个属性:输入数据的敏感级别、输出是否回写内网、调用量级。三个属性标完,任务清单自然分成几堆,架构方案从里面长出来,而不是先画架构图再找任务往里塞。
组合架构因此成为默认选项
数据分级的直接推论是:多数企业的 AI 架构会是组合形态。端侧处理敏感与高频部分,云端承担公开与重算力部分,两者之间只传递必要的结果信息。这种形态下,数据边界是设计出来的——每类数据有明确的去处,而不是笼统地「都上云」或「都本地」。
政务、金融、制造行业的新建项目普遍采用这类设计,原因无他:合规审查是硬门槛,数据流向清晰才可能通过。