推理引擎的工程取舍:企业选型时该看什么
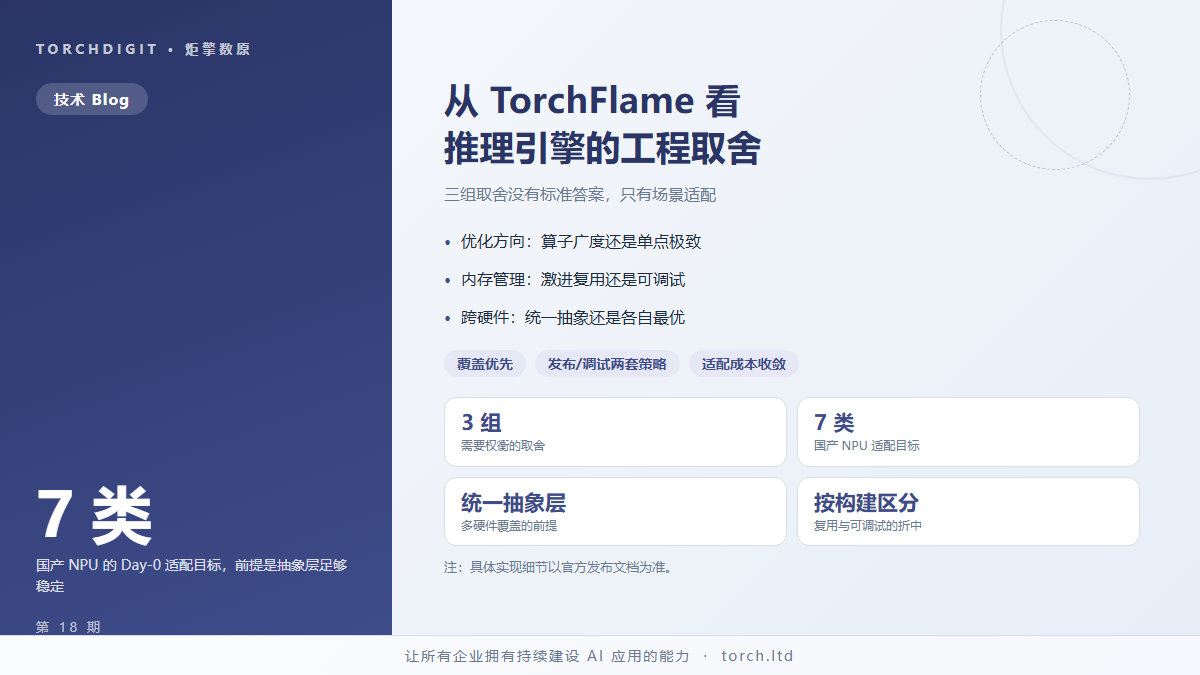
推理引擎是端侧部署里最不显眼、却最决定成败的一层。模型与硬件之间隔着它,量化方案要靠它落地,性能上限由它决定。这一层必须面对几组取舍——这些取舍没有标准答案,只有适配场景的选择,而选型判断恰恰藏在这些取舍里。
取舍一:算子覆盖广度还是单点极致
第一个取舍在优化方向上。引擎可以选择把少数热点算子做到极致,也可以选择把算子覆盖做全,保证任意模型都能跑起来。
前者的收益体现在基准测试上,代价是遇到未覆盖的算子时需要回退实现,性能断崖式下跌。后者的收益是兼容性,代价是整体性能难以逼近硬件上限。
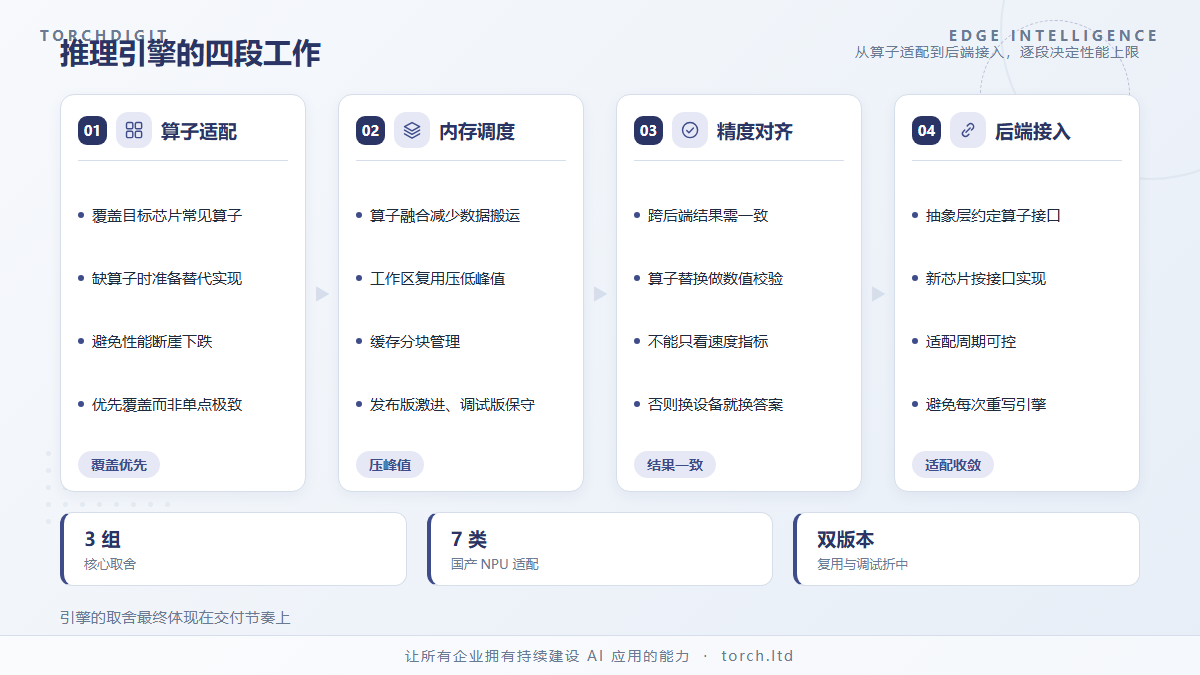
面向企业部署的引擎通常偏向后一条路。生产环境中模型会迭代、算子组合会变化,一个「大多数情况很快、少数情况跑不动」的引擎,比一个「所有情况都还行」的引擎风险更高。因此在评估引擎时,算子覆盖情况比单项基准分数更值得追问:CPU 与 NPU 两条路径的常见算子是否补齐,遇到未覆盖算子时回退路径是否可用。
取舍二:内存复用还是可调试性
第二个取舍在内存管理上。为了压低峰值占用,引擎会做激进的内存复用:不同算子的工作区重叠使用同一块内存,生命周期结束时立即回收。这能显著降低内存门槛,也让故障排查变得困难——一块内存被反复覆写,出问题时很难定位是哪一步写坏的。
保守的实现会为每个算子保留独立工作区,调试友好但内存占用高。端侧设备内存紧张,多数引擎最终选择偏激进的复用策略,并用额外的机制来补偿可调试性:分阶段的内存快照、可开关的校验模式、以及在测试环境下自动记录内存操作序列。
这个取舍没有一劳永逸的解法,实际做法是按构建类型区分:发布版本走激进复用,调试版本走保守策略。
取舍三:后端统一还是各自最优
第三个取舍在跨硬件适配上。不同 NPU 的指令集、算子库、编译链各不相同,引擎可以为每个后端单独写一套最优实现,也可以维护一套统一抽象层、由后端插件填充差异。
单独实现能榨出更高性能,但适配成本随硬件型号线性增长,新芯片支持周期长。统一抽象层牺牲一部分峰值性能,换取适配速度——新后端接入只需实现约定好的算子接口。
对需要覆盖多类国产芯片的场景,统一抽象层几乎是必然选择。要让多类国产 NPU 都能快速接入,前提是这套抽象层足够稳定,能把适配工作收敛到接口实现上,而不是每次重写引擎。