国产 NPU 适配背后:信创环境 AI 落地的工程成本
信创环境里跑 AI,多数人的关注点在「模型能不能用」,实际耗费时间最多的是「怎么让它在这块芯片上跑起来」。国产加速卡型号多、工具链版本杂、算子覆盖不一致,适配工作是项目排期里最容易被低估的一段。
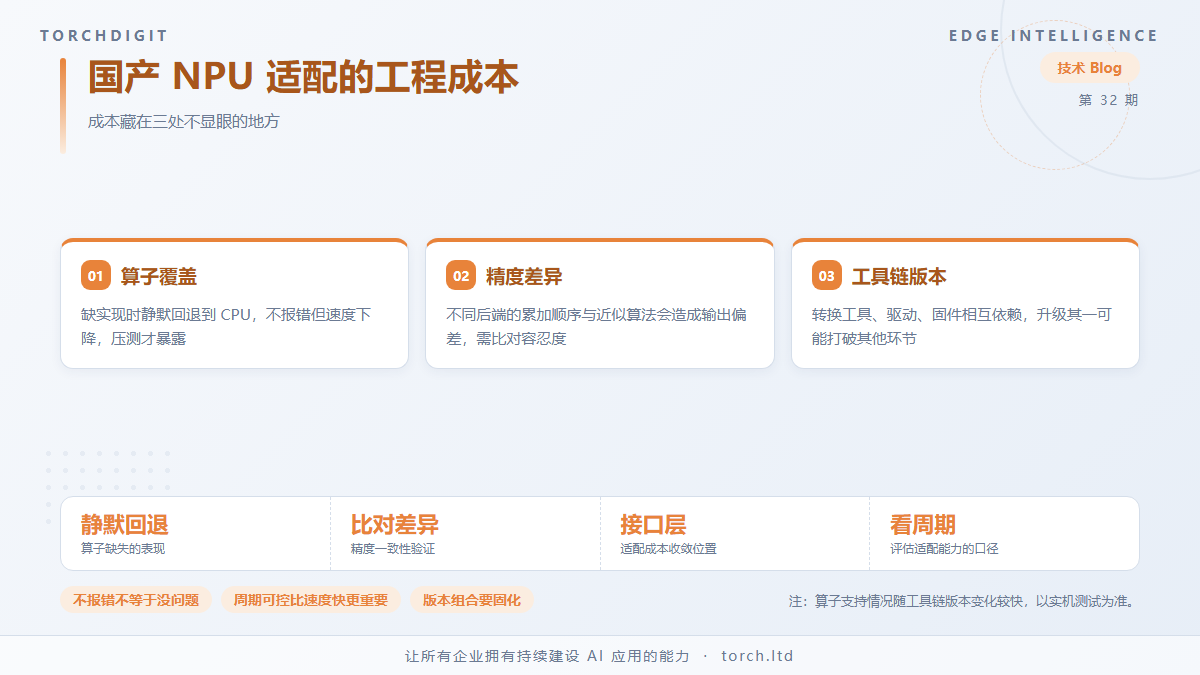
工程成本藏在三处不显眼的地方
第一处是算子覆盖。各家加速卡的算子库成熟度不同,主流模型里总有几个算子没有对应实现。缺少实现时通常回退到 CPU 执行,速度会明显下降,但不报错,因此在测试阶段容易被忽略,直到压测时才暴露。
第二处是精度差异。同一模型在不同加速卡上计算,浮点累加顺序与近似算法的差别会造成输出偏差。多数任务里这种偏差可以接受,但在需要严格一致性的场景里,会导致同样的输入产生不同结论。
第三处是工具链版本。模型转换工具、驱动、固件之间存在版本依赖,升级其中一个可能打破其他环节。这类问题在单一环境里好处理,在多厂区、多批次的设备上会成倍放大。
适配工作应该收敛到接口层
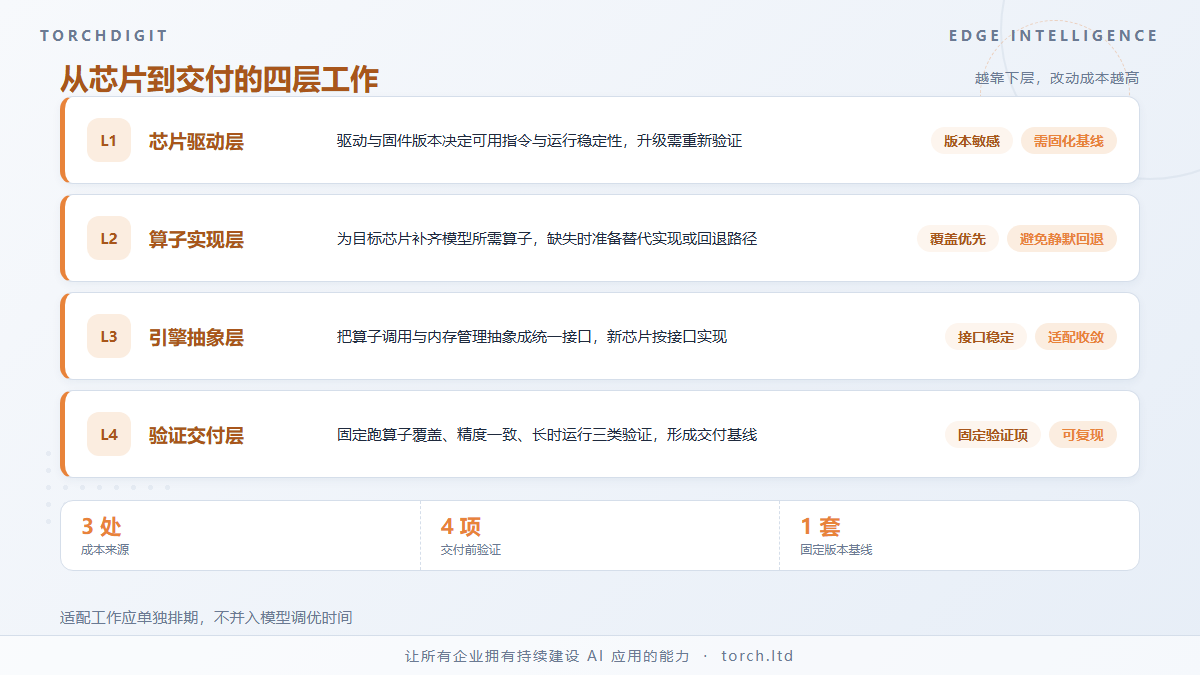
如果每个新芯片都要重写一遍引擎,成本会随型号数量线性上升。更可行的做法是在引擎内部加一层抽象:把算子调用、内存管理、同步机制抽象成统一接口,新芯片的接入工作就变成实现这组接口。
这样做有两个前提。一是抽象层的接口要稳定,频繁变动会让已有的适配失效。二是要有回退路径,新芯片的某些算子暂时没实现时,能通过替代实现或 CPU 路径跑通,而不是整个模型不可用。
适配周期的可控性,比单次适配速度更重要。评估一个方案时,值得问的是:从拿到一块新芯片到模型可跑,需要多长时间;这个时间是否随型号增加而增长。
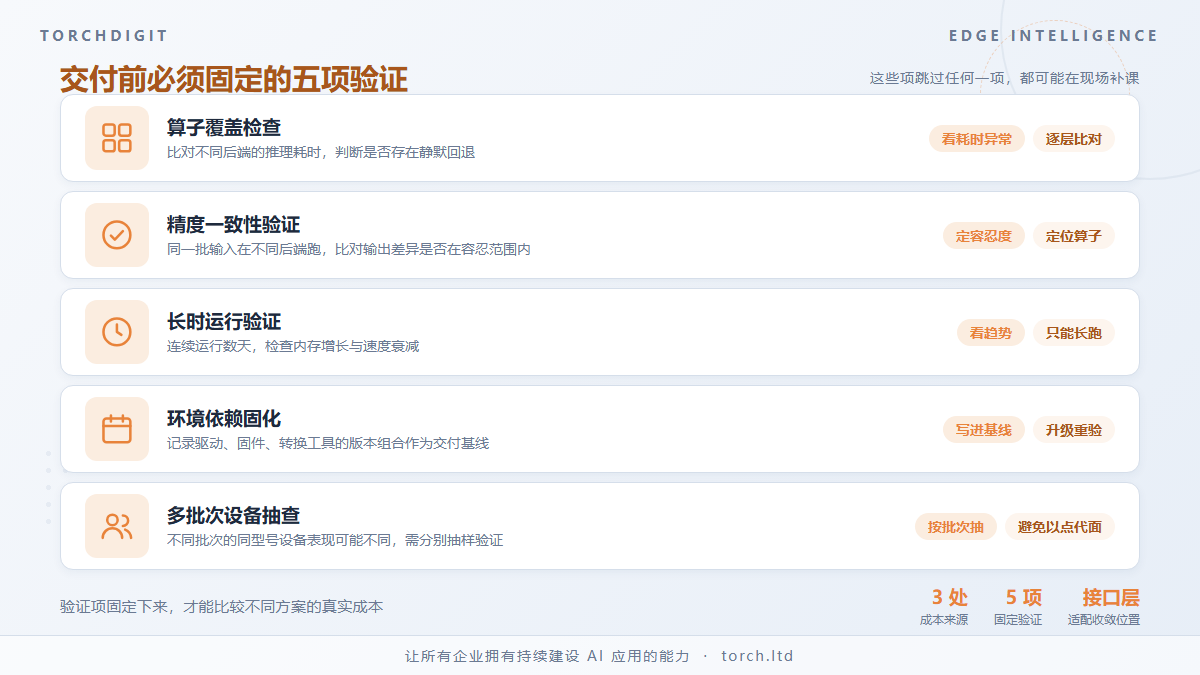
交付前要做的验证项
在信创环境交付前,建议固定跑一遍这几项。
算子覆盖检查:在目标芯片上跑目标模型的全部算子,确认没有静默回退。做法通常是比对不同后端下的推理耗时,若某个环节显著慢于其他后端,多半存在回退。
精度一致性验证:同一批输入在不同后端上跑,比对输出差异。差异超出业务容忍范围时,需要定位到具体算子。
长时运行验证:连续运行数天,观察是否存在内存增长与速度衰减。低精度路径下的内存泄漏与碎片问题,往往在长跑后才显现。
环境依赖固化:把驱动、固件、转换工具的版本组合记录下来并固定,作为交付基线。后续任何升级都要重新验证,而不是直接替换。