制造业 AI 落地的真实门槛:不是模型,是数据与流程
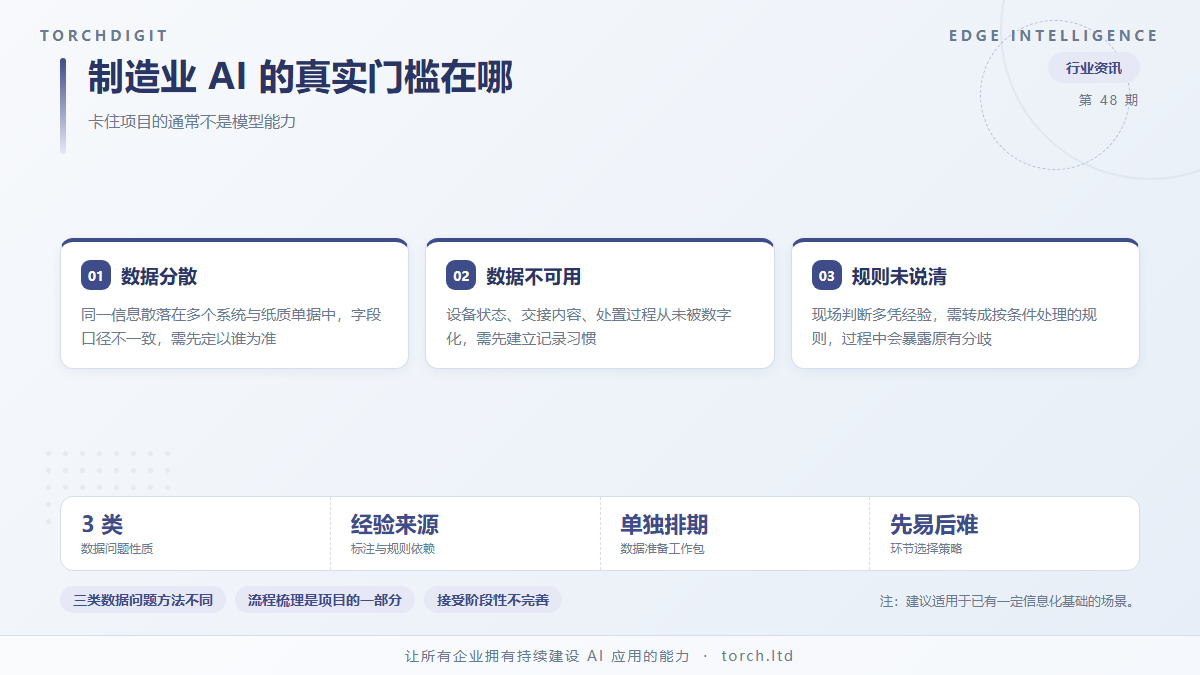
制造业上 AI 项目,失败的原因很少是模型能力不够。更多时候,项目在数据与流程上卡住:数据散落在不同系统里、格式不统一、关键信息靠人工记录;流程本身没有明确规则,无法转成系统可执行的判断。模型选型反而是整个链条里最容易被解决的一环。
数据问题有三类,性质不同
第一类是数据分散。同一批物料的信息可能在 ERP、台账、纸质单据里各有一份,字段口径还不一致。AI 应用要处理这些数据,先要解决取哪一份、以谁为准的问题。
第二类是数据不可用。有些信息从未被数字化,比如设备状态、班组交接内容、异常处置过程。这类数据需要先建立记录习惯,才谈得上分析。这个阶段的工作量常常被低估,因为它不属于技术范畴。
第三类是数据不标注。有了数据但没有标注,模型无法判断对错。制造业的标注往往需要老师傅的经验,而老师傅的时间稀缺,标注质量与速度都受制约。
三类的处理路径完全不同:分散靠梳理与打通,不可用靠流程改造,不标注靠经验沉淀。把它们统称为「数据问题」,容易导致用错方法。
流程问题在于规则没有被说清楚
制造现场的很多判断依赖经验,而非成文规则。同一个异常,不同班组的处理方式可能不同,老员工凭感觉就能判断,新员工需要问人。
AI 应用要把这类判断交给系统,前提是规则被明确表达出来。这需要把「凭经验」转成「按什么条件做什么处理」,这个过程往往暴露出原本存在的分歧:同一件事不同人理解不同,或者部分情况从未被考虑过。
因此流程梳理不是技术工作的前置准备,它本身就是项目的一部分,且往往是最耗时的部分。
迈过门槛的几个建议
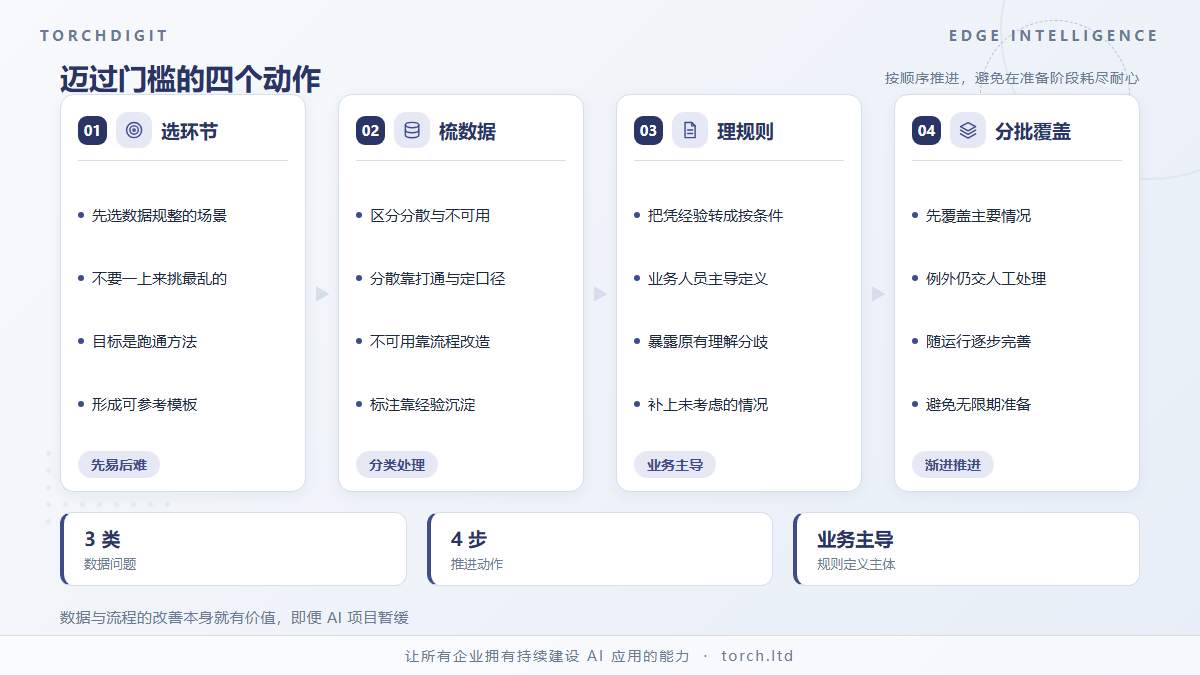
先选数据基础较好的环节。不要一开始就选数据最乱的场景,那会让项目在准备阶段耗尽耐心。选一个数据相对规整、流程相对清晰的环节先跑通,形成可参考的方法。
把数据准备单独排期。数据梳理与标注是独立的工作包,需要单独的人与时间,不能作为技术任务的附属品。
让业务人员参与规则定义。规则来自业务经验,技术团队无法代劳。让熟悉业务的人参与,写出的规则才贴近实际。
接受阶段性不完善。全部数据都规范、全部规则都成文之后再上系统,周期会长到项目失去支持。更可行的做法是先覆盖主要情况,把例外交给人工,随运行逐步完善。