模型开源对使用方意味着什么
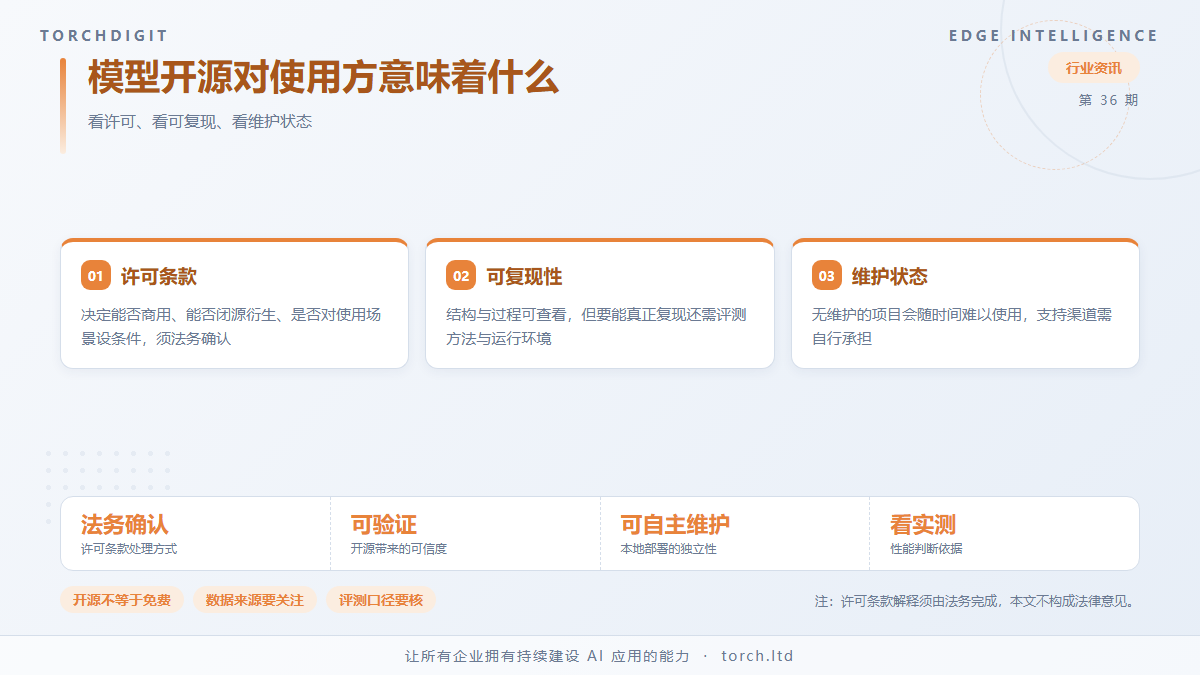
模型开源常被当成一个加分项,但对企业使用方来说,它的实际含义需要具体分析。开源改变了你能做什么、也改变了你要承担什么。判断一份开源模型是否值得采用,要看许可条款、可复现性与维护状态三件事,而不是看它是否贴着开源标签。
开源不等于无约束,许可条款决定能怎么用
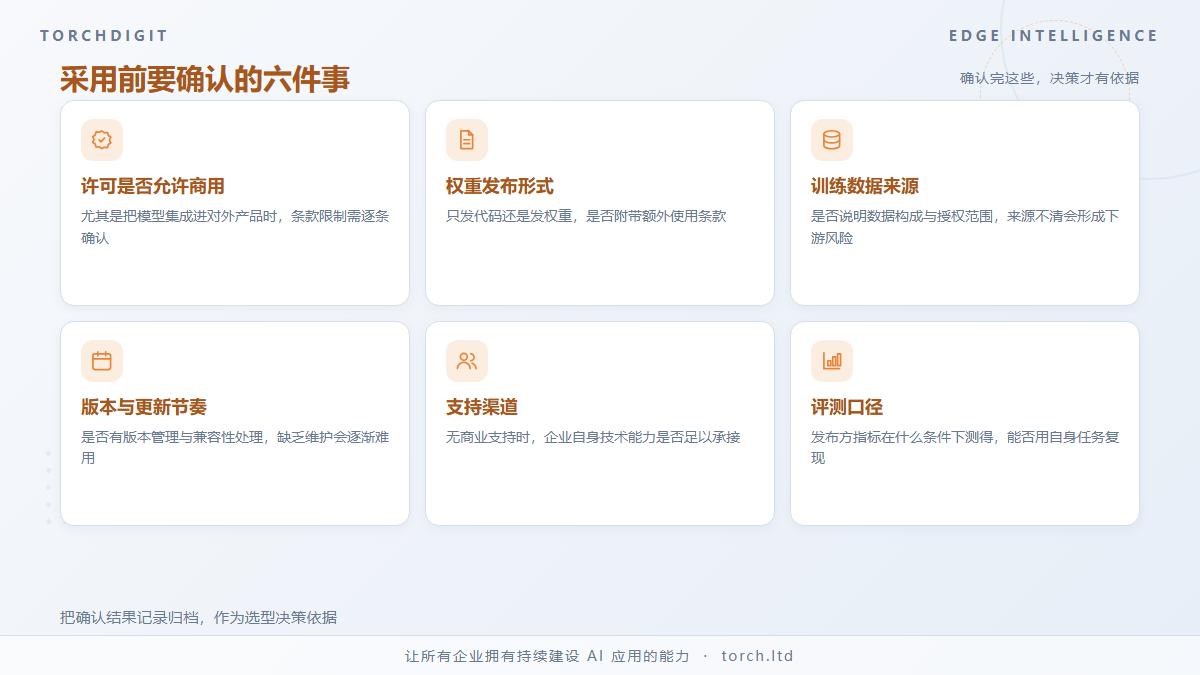
不同开源许可对使用方式有不同限制。有的允许商业使用并允许修改后闭源,有的要求衍生作品同样开源,还有的对使用场景设有条件。企业引入前需要由法务确认条款,尤其是打算把模型集成进对外产品时。
除了许可,还要看权重的发布形式。有的只发布推理代码,权重需要另行获取;有的发布权重但附带额外条款。这些差异会直接影响部署与分发的合规性。
另一个常被忽略的是训练数据的来源声明。部分开源模型会说明数据构成与授权范围,部分则语焉不详。数据来源不清会在下游使用时形成潜在风险,尤其在对合规要求较高的行业。
可复现性决定能否长期依赖
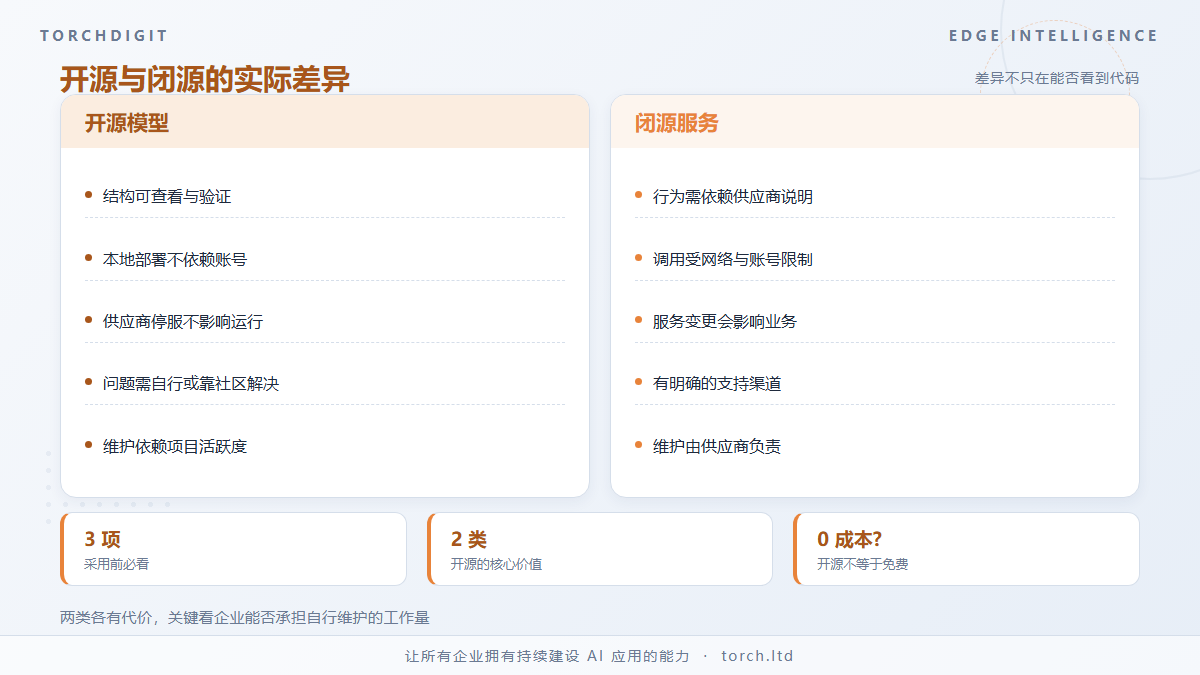
开源的第一个价值是可信。你可以看到模型的结构与推理过程,能自己验证行为是否符合描述,而不必完全依赖供应商的说明。这在需要向监管或客户解释系统行为的场景里尤其重要。
第二个价值是可自主维护。模型在本地部署后,不会因为供应商停止服务而失效,也不受网络与账号限制。对长期运行的系统来说,这种独立性有价值。
但可复现性不是自动获得的。要能真正复现,还需要评测方法、量化流程与运行环境都可获得。只有权重而缺乏这些配套,实际使用中仍会遇到大量需要向原作者确认的问题。
采用之前要确认的事项
版本与更新节奏。确认是否有明确的版本管理与更新计划,以及新旧版本之间的兼容性如何处理。缺乏维护的开源项目会随时间推移逐渐难以使用。
支持渠道。开源不提供商业支持,遇到问题只能靠社区或自行解决。企业需要评估自身技术能力是否足以承担这部分工作。
性能与资源的匹配。开源模型的规格是固定的,需要确认它在目标硬件上的实际表现,而不是依据发布方的说明判断。
评测口径。确认发布方给出的指标是在什么条件下测得的,是否能用自己的任务复现。