知识密度是什么?为什么它比参数量更能说明端侧模型能力
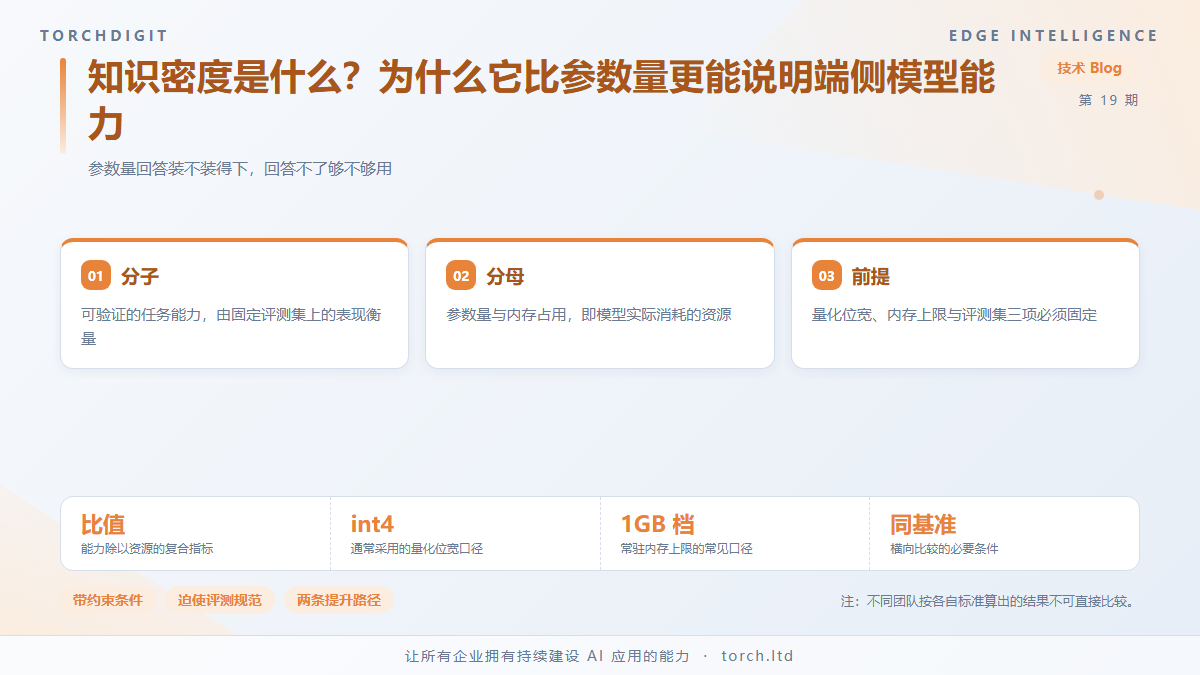
在云端模型的世界里,参数量长期被当作能力的粗略代理:更大的模型通常更强,缩放规律也确实成立。但这套逻辑在端侧遇到硬约束。设备的内存与算力上限决定了参数规模的天花板,此时「把模型做大」不再是一个可选动作,比较的维度必须换一个。知识密度这个指标,就是为了回答端侧场景下的能力问题而出现的。
参数量为什么在端侧失效
参数量本身只是容量的度量,它说明模型有多少存储空间,不说明这些空间被用于什么。两个参数量相同的模型,一个经过高质量数据训练与针对性蒸馏,另一个用常规语料训练,下游任务表现可能相差明显。它们在参数表上完全一样。
在云端,这个差别可以通过继续放大规模来掩盖——参数翻倍通常能补上质量差距。端侧没有这个空间,参数规模被内存锁死,质量差距就直接暴露成能力的差距。因此参数量在端侧只能回答「装不装得下」,回答不了「够不够用」。
知识密度度量的是什么
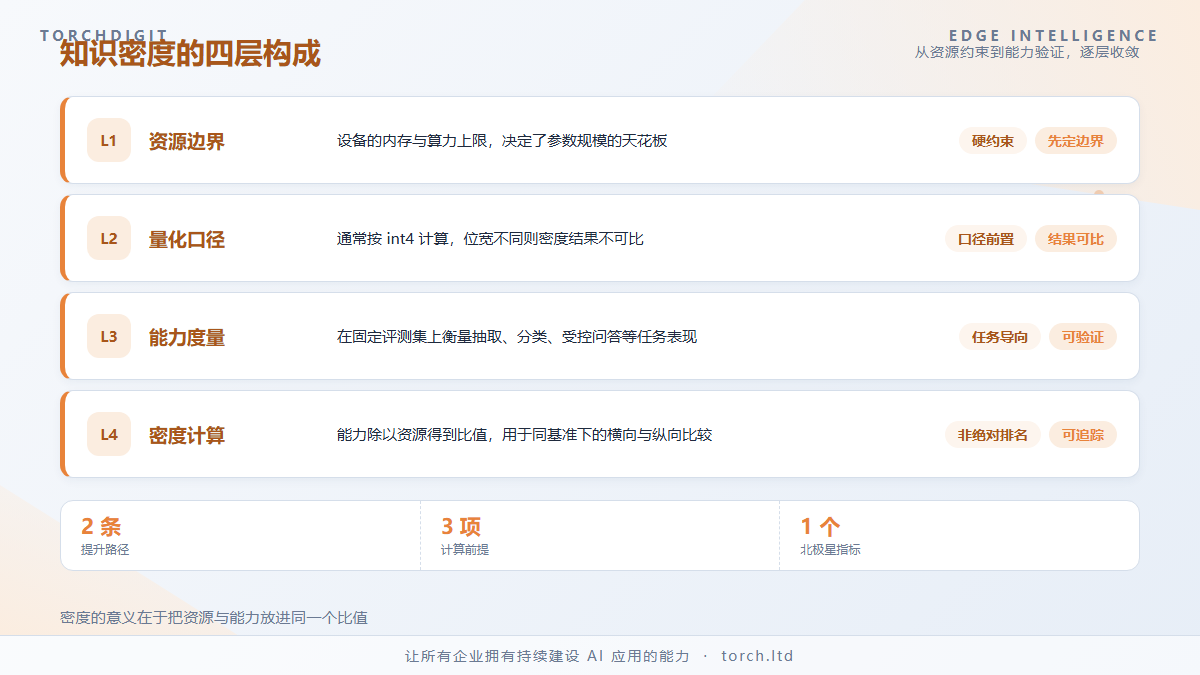
知识密度的定义是单位资源承载的有效知识量。它把参数量与内存占用放在分母上,把可验证的任务能力放在分子上,得到的是一个比值而不是绝对量。
这个构造方式带来两个直接好处。第一,它天然带约束条件,衡量的是「在限定资源内能做到什么」,与端侧的实际决策方式一致。第二,它迫使比较发生在同一基准上——脱离了测试集与量化方案谈密度没有意义,这反过来推动了评测流程的规范化。
要计算这个指标,需要三个确定的前提:量化位宽(通常按 int4)、常驻内存上限(比如 1GB 量级)、以及一组覆盖企业高频任务的评测集。三个前提固定之后,不同模型的密度才具备可比性。
为什么它对端侧判断更有用
端侧选型时的真实问题不是「哪个模型最强」,而是「在既有设备上,哪个模型能完成我的任务」。
用知识密度回答这个问题,路径更短:先确定设备能提供的资源边界,再看哪些模型能落在这个边界内,最后在同一评测集上比较它们的能力表现。这个过程不需要假设「稍大一点会更好」,也就避免了为追求参数而被迫更换硬件的连锁反应。
它同时解释了端侧工程的方向。既然密度是分子除以分母,提升路径就只有两条:在资源不变的前提下提升能力,或者在能力不变的前提下压缩资源。量化、蒸馏、数据治理、架构调整,全都归入这两条路径之一。