常规单据自动通过、异常回到人工,这条线该画在哪
流程自动化的核心不是把人工全部替换掉,而是决定哪些单子可以自动走完、哪些必须停下来等人判断。这条线画得太松,错误会溜过去;画得太紧,人工量降不下来,项目就失去了意义。合理的做法是按风险与置信度分层,而不是设一个统一的准确率门槛。
只看准确率定阈值,会把风险平均化
最常见的做法是取一个整体准确率作为阈值:达到就自动通过。这个方法简单,但会把不同性质的风险混在一起。
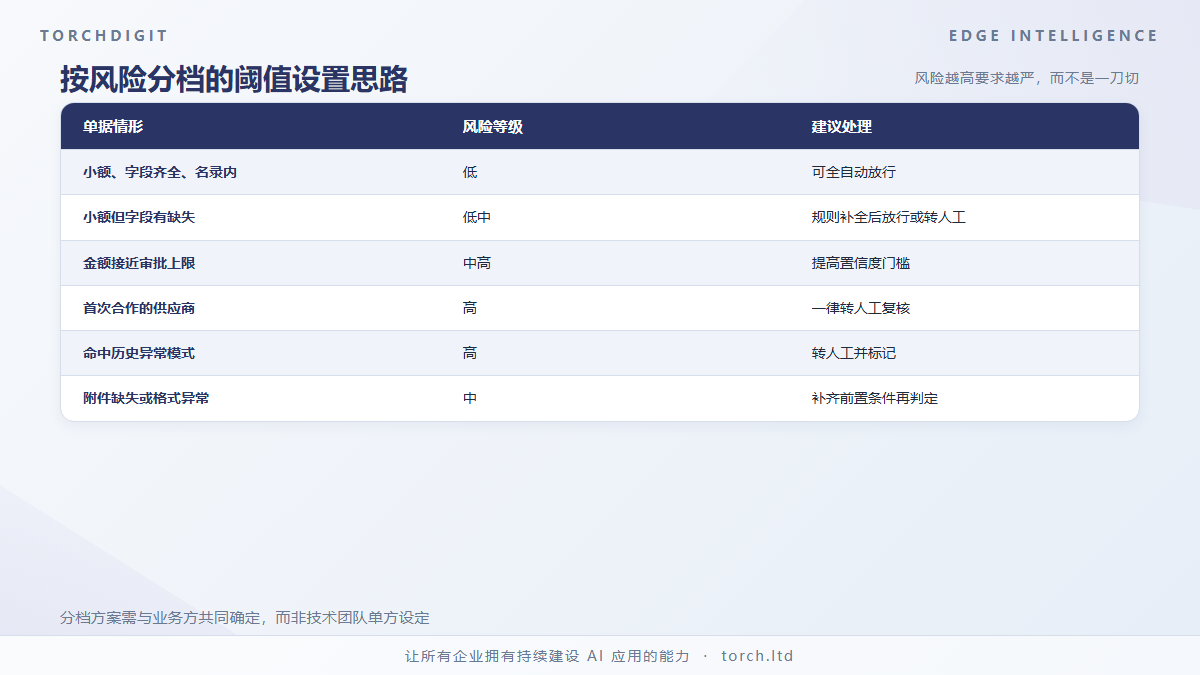
一张金额很小、字段齐全、供应商在名录内的采购申请,与一张金额接近审批上限、附件缺失、供应商是新增的申请,虽然模型都可能给出较高的置信度,但出错代价完全不同。用一个统一阈值处理两者,要么是前者被无谓地拦下,要么是后者被放过。
所以阈值应该按单据类型与金额区间分别设定。风险越高的组合,要求越严;风险低的组合,可以放宽甚至全自动。
三类信号决定能不能自动通过
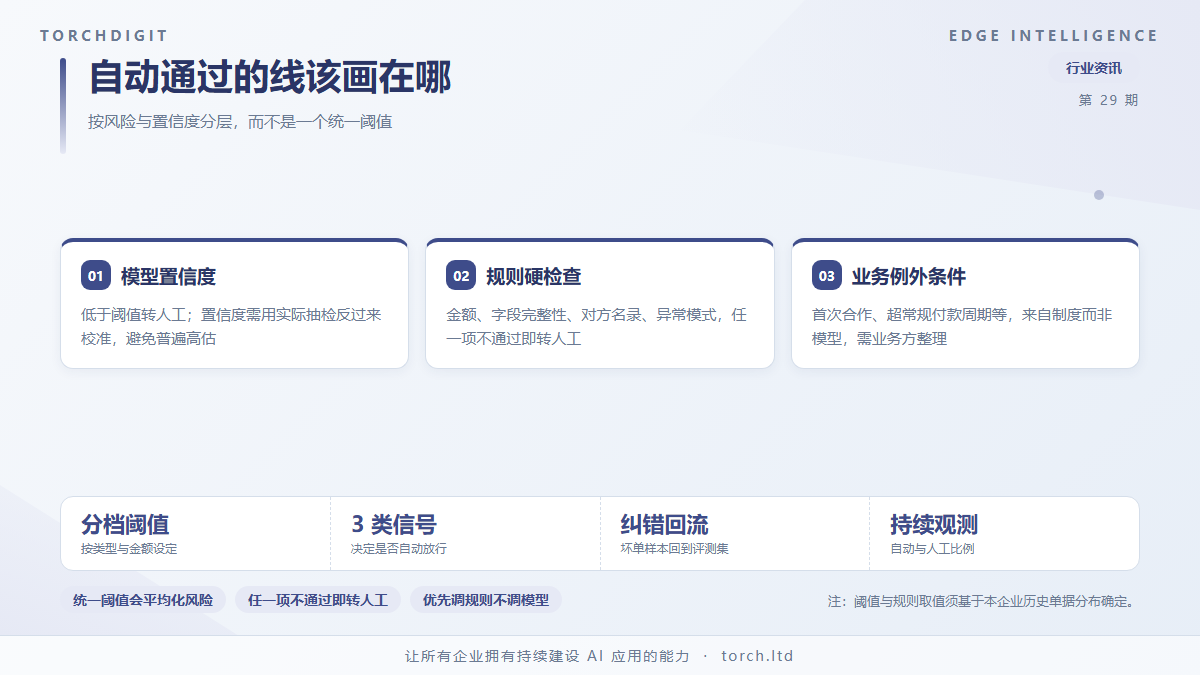
判断一张单据能否自动走完,可以看三类信号。
一是模型置信度。低于设定值时转人工,这是最基础的判断。要注意置信度的校准,如果模型普遍高估自己,阈值就形同虚设,需要用实际抽检结果反过来校准。
二是规则的硬性检查。金额是否超限、字段是否缺失、对方是否在名录内、是否与历史异常模式相似。这类检查不依赖模型,结论确定,应当作为独立的一层,任一项不通过就转人工。
三是业务的例外条件。某些字段组合天然需要人看,比如首次合作的供应商、超出常规的付款周期。这类条件往往写在制度里而不是模型里,需要与业务方一起整理,并要求完整覆盖。
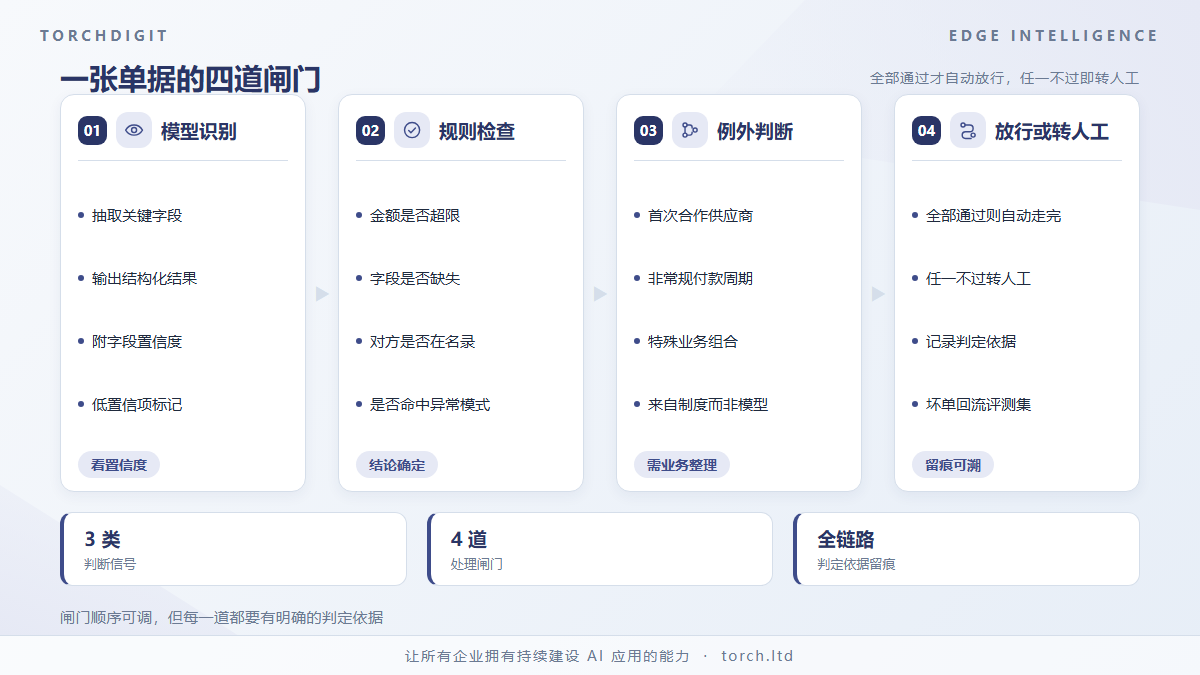
三类信号中任何一类不通过,就转人工。只有全部通过,才自动放行。
自动化比例要能被追踪和调整
上线之后,自动通过比例与人工介入比例都应该被持续观测,并且能定位到原因。如果人工介入率一直很高,要能区分是模型不稳、还是规则过严、还是业务例外条件列得太多。
调整时优先动规则而不是动模型。规则变更快、影响可控、可随时回退;模型变更周期长、影响面大。实践中多数比例失衡问题出在阈值与规则上,而不是模型能力不足。
另一个要提前准备的是纠错通道。自动通过的坏单被下游发现后,需要有机制把这一单的样本回流到评测集,并触发阈值或规则的复核。没有回流通道,同类错误会反复出现。