AI 应用上线前为什么必须配安全门禁与回滚
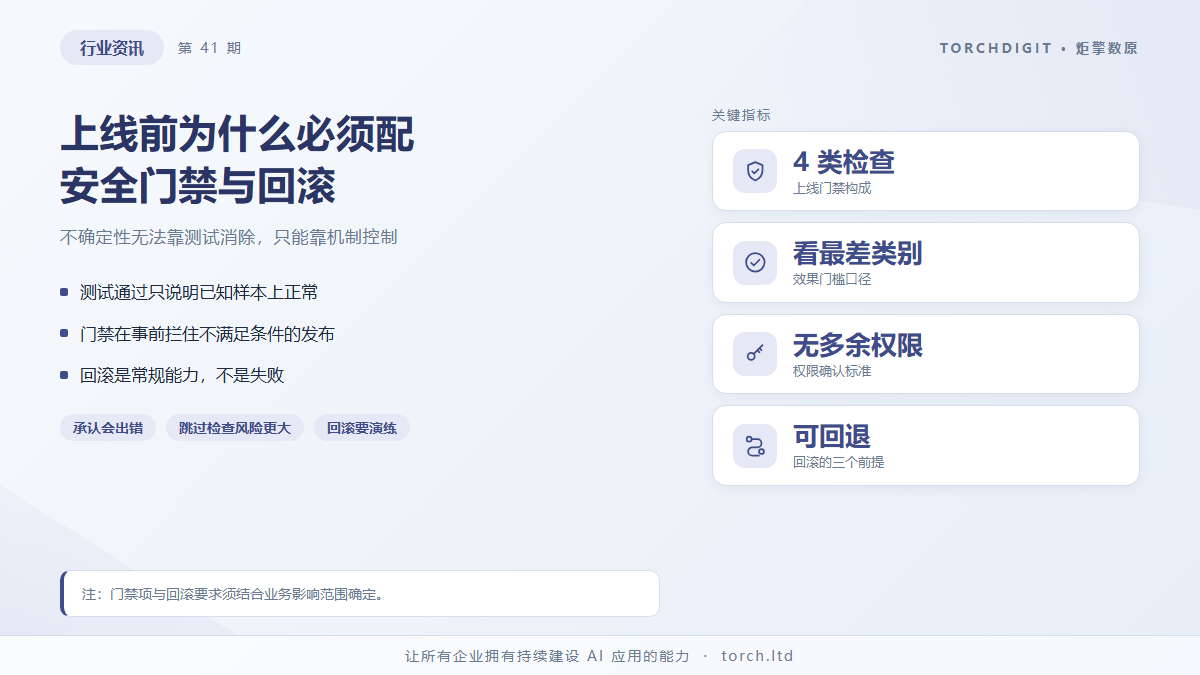
AI 应用与传统软件的区别在于,它的输出带有不确定性:同样输入可能给出不同结果,遇到没见过的输入可能给出看似合理但错误的答案。这种不确定性无法通过测试完全消除,只能通过上线前的门禁与上线后的回滚来控制影响范围。这两件事不是可选项。
不确定性无法在测试阶段消除
传统软件的缺陷可以通过测试发现并修复,因为行为是确定的:同样的输入必然产生同样的输出。测试覆盖到的路径不出问题,基本可以认为系统是可靠的。
AI 应用不满足这个前提。模型对输入的处理是概率性的,测试集覆盖不到的输入形态上,行为无法预测。这意味着「测试通过」只能说明在已知样本上表现正常,不能保证线上不会出问题。
既然不能通过测试消除,就需要换一个思路:承认会出错,把重点放在出错时的影响可控上。这正是门禁与回滚要解决的问题。
门禁管的是「什么条件下允许上线」
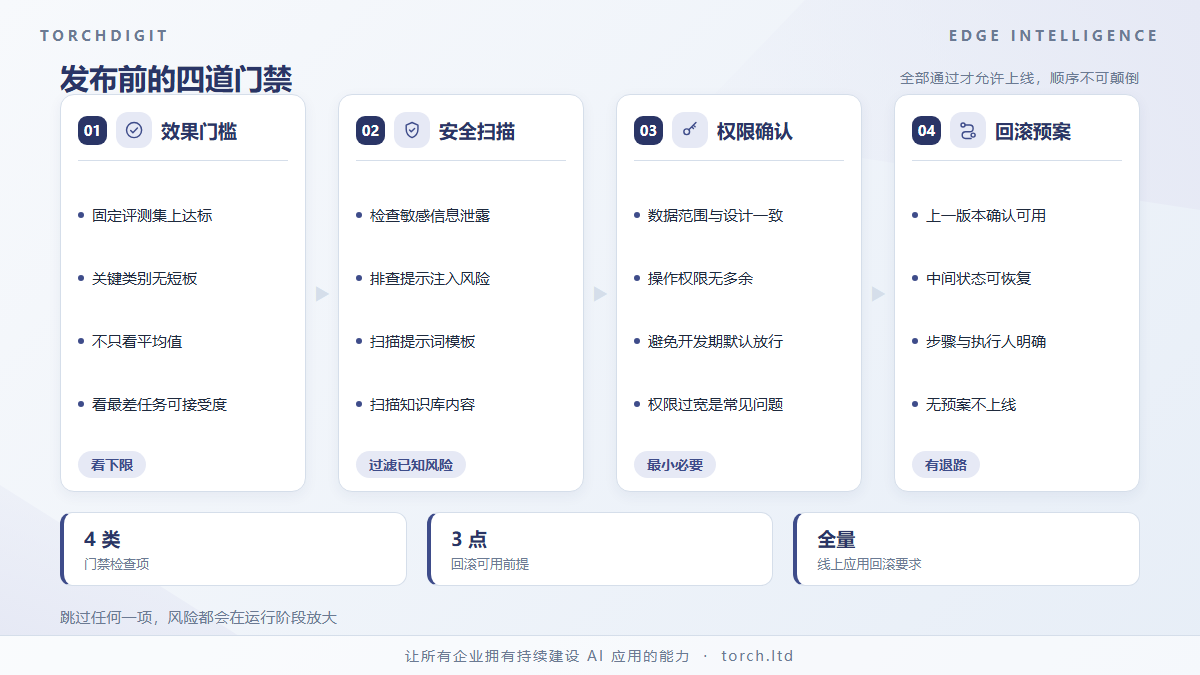
门禁是一组前置检查,只有全部通过才允许发布。对 AI 应用来说,至少应包含四类。
效果门槛。在固定评测集上的表现达到预设标准,且关键类别没有明显短板。只看平均值不够,要看最差的那几类任务是否可接受。
安全扫描。检查是否存在敏感信息泄露、提示注入等风险点。生成的提示词模板、知识库内容、对外接口都需要扫描。
权限确认。确认应用能访问的数据范围与操作权限符合设计,没有多余的权限。权限过宽是常见问题,往往在开发便利性下被默认放行。
回滚预案。确认上一版本可用、数据可恢复、回滚操作有明确执行人和步骤。没有回滚预案就不应该上线。
四类检查通过后才允许发布,这个顺序不能省。跳过任何一项,风险都会在运行阶段暴露,而那时的影响范围更大。
回滚不是倒退,是控制影响范围的必要手段
把回滚理解为失败,会导致团队在上线后不愿回退,宁可花时间在前向修复上,问题影响面因此扩大。
更合理的定位是把回滚当作常规能力:一旦发现异常,第一时间回退到稳定版本,恢复业务,再从容排查原因。这样处理的代价是回退期间的业务损失,比带着问题继续运行要小得多。
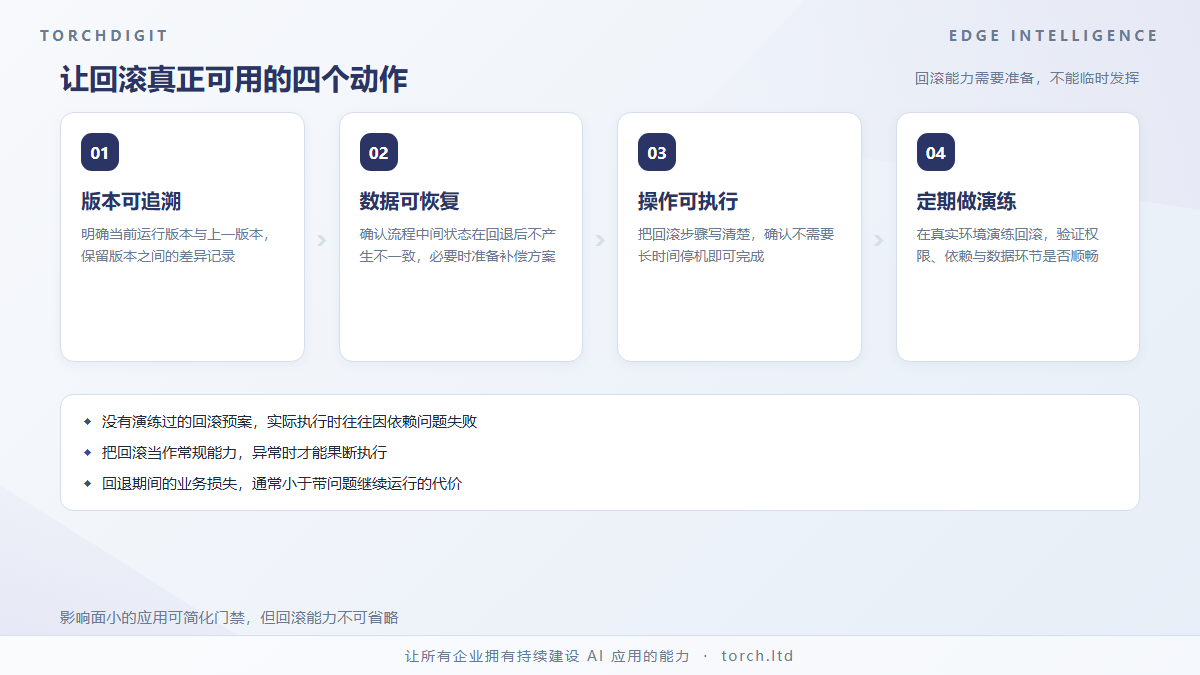
要让回滚真正可用,需要几个前提。版本可追溯,知道当前运行的是哪一版、上一版是什么。数据可恢复,流程中产生的中间状态在回退后不会造成不一致。操作可执行,回滚动作有明确步骤且不需要长时间停机。这三点需要在设计阶段就考虑,而不是上线后临时准备。