离线评测集 + 灰度发布:让 Agent 上线可控的方法
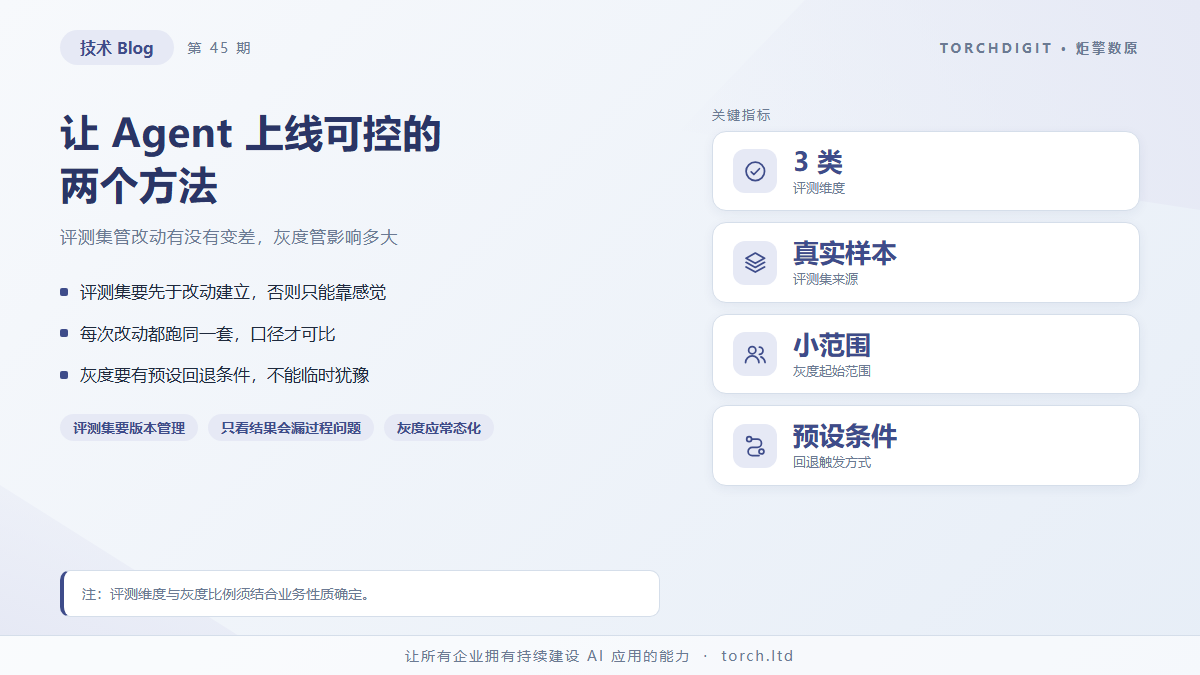
智能体上线最难的不是让它跑起来,而是让它的变化可控。模型升级、提示词调整、知识库更新,这些改动都会改变行为,而改变未必是改善。离线评测集解决「改动有没有变差」,灰度发布解决「变差了影响多大」。两者配合,才能把风险限制在可接受范围内。
离线评测集要先于改动建立
评测集的价值在于提供对照基准。没有基准,改动只能靠感觉判断,而感觉在复杂任务上并不可靠。
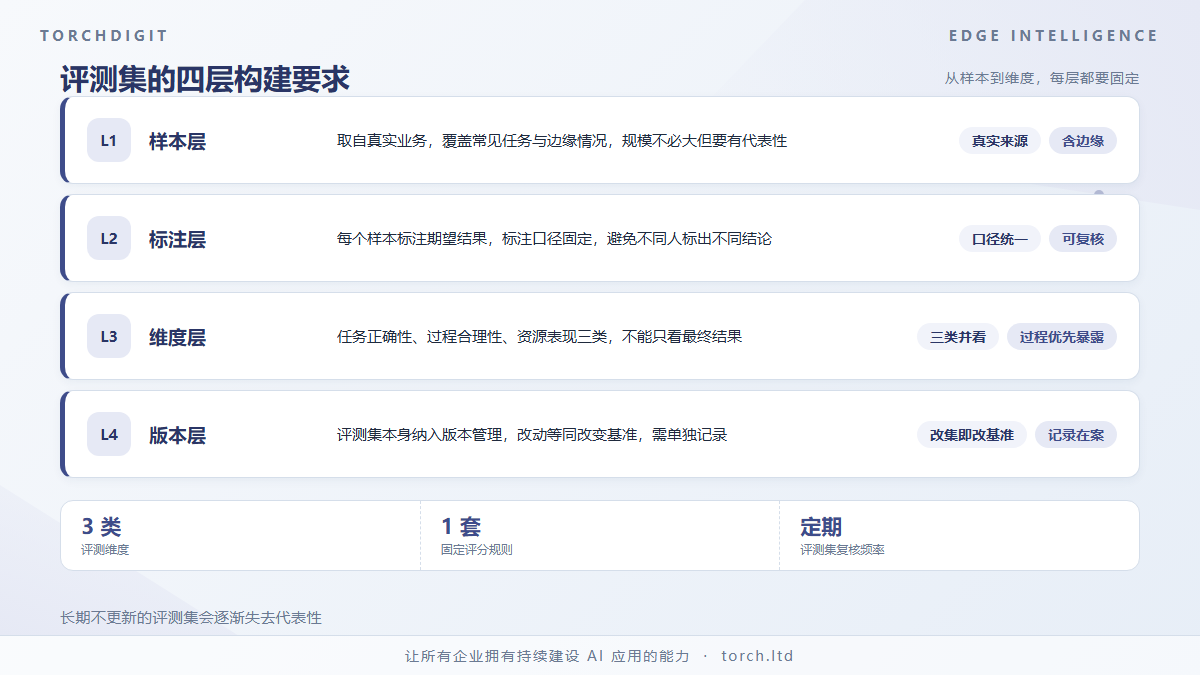
建立评测集有几个要点。样本来自真实业务,覆盖常见任务与边缘情况,规模不必大但要有代表性。每个样本需要标注期望结果,标注口径要固定,避免不同人标注结果不一致。评测集本身要版本管理,改动评测集等同于改变基准,需要单独记录。
评测维度应包含至少三类:任务正确性,即结果是否符合预期;过程合理性,即调用路径是否合理、是否有多余步骤;资源表现,即耗时与调用次数是否在预期范围。只看最终结果容易漏掉过程性问题,而过程问题往往先于结果问题暴露。
每次改动都跑同一套评测
评测集建立后,关键在于坚持使用。任何影响行为的改动,包括模型替换、提示词修改、阈值调整、工具接口变更,都应先跑一遍完整评测。
比较方式要注意口径一致。使用同一份评测集、同一套评分规则、同一组参数配置。硬件或依赖变化时,结论的可比性会下降,需要在记录中注明。
评测结果不理想时的处理也要有规则。是退回改动,还是接受性能下降但换取了其他收益(如成本降低),这类决策应由业务方参与,而不是技术团队单方面判断。
灰度发布控制影响范围
评测再充分,也无法覆盖线上全部情况。灰度发布的作用是让改动先在小范围内运行,观察实际表现后再决定是否扩大。
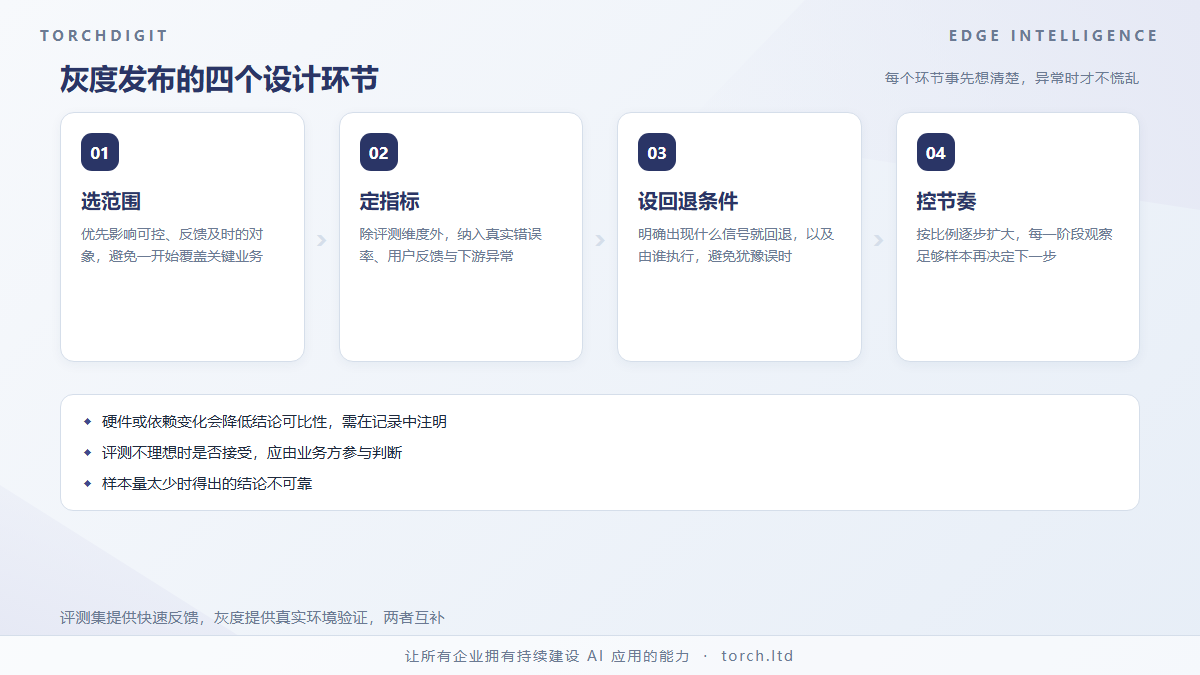
灰度设计要考虑几个方面。范围选择上,优先选择影响可控、反馈及时的对象,避免一开始就覆盖关键业务。观察指标除评测维度外,还应包括线上特有的指标:真实错误率、用户反馈、下游系统的异常。
回退条件要提前设定,明确出现什么信号就回退,以及由谁执行。没有预设条件的灰度,容易在犹豫中错过最佳回退时机。
推进节奏建议按比例逐步扩大,每一阶段观察足够的样本量再决定下一步,避免样本太少导致结论不可靠。