POC 测试集怎么建:样本选择与评价口径的工程方法
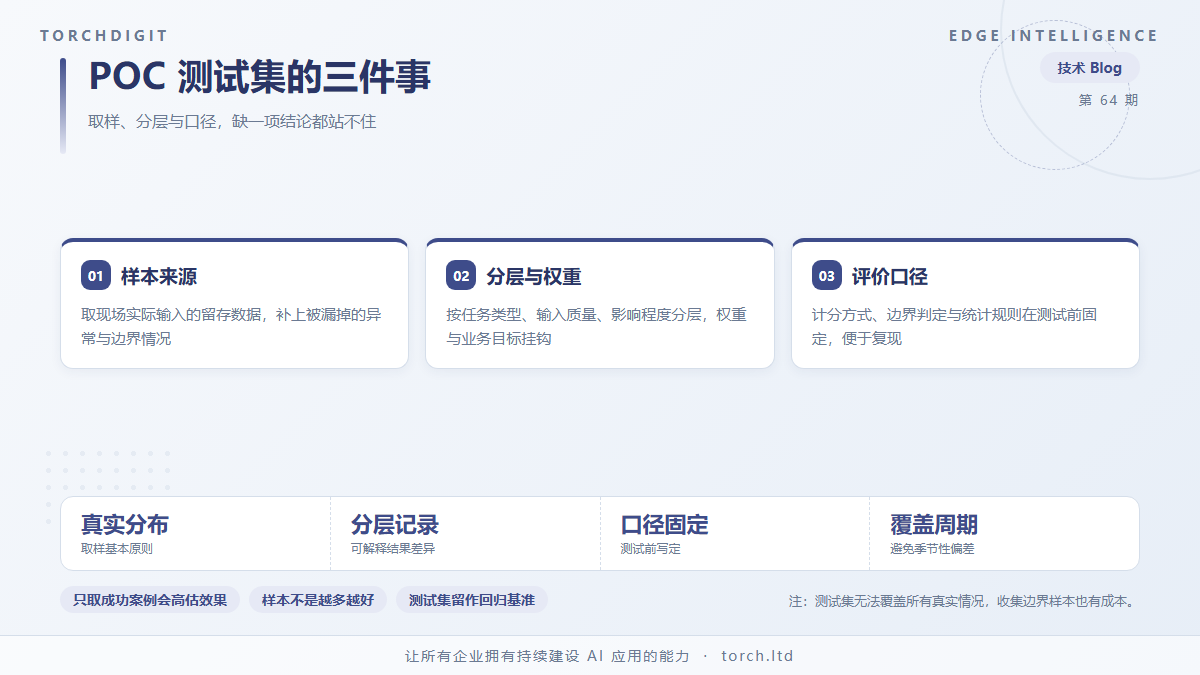
POC 结论的可信度,很大程度上取决于测试集是怎么建的。样本选偏了,结果会系统性偏离;评价口径没定清,同一批样本可以得出不同结论。这两件事都属于工程问题,有相对固定的做法可循。
样本要从真实分布里取
测试集的价值在于反映真实情况,因此样本来源应当是现场实际产生或历史留存的输入,而不是人工构造或经过整理的样例。
取样的一个常见错误是只取成功案例。历史留存的数据里,处理成功、格式规范的部分容易被提取,而异常的、边界的情况往往散落在其他系统或根本没有记录。这会系统性高估效果。
可行的补充办法是把边界样本单独整理。近半年的异常单据、被人工退回的任务、格式不规范的输入,都值得纳入。这部分样本不必多,但要覆盖到。
取样还要注意时间跨度。业务规则会变化,只用最近一个月的数据,覆盖不到季度性波动;只用一年前的数据,又可能不符合当前规则。
分层与权重需要先定
测试集不是样本越多越好。同样的样本量,分布不同会得出不同结论。因此需要先确定分层方式与各层权重。
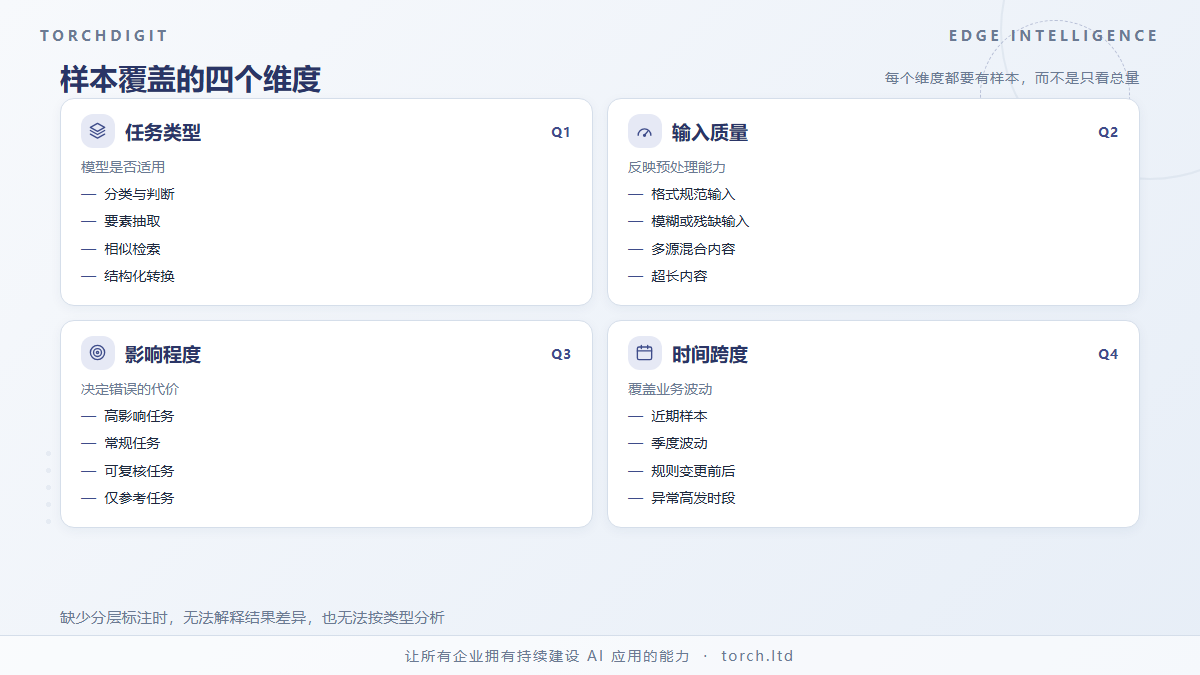
常见的分层维度有三个:任务类型、输入质量、业务影响程度。任务类型决定模型是否适用;输入质量反映预处理能力;业务影响程度决定错误的代价。
权重设置与业务目标相关。如果目标是减少人工介入,高影响任务的权重应当更高;如果目标是降低整体处理时间,则要考虑各类型任务的真实占比,而不是平均分配。
分层信息要记录在样本上,而不只是记录总量。缺少分层标注时,后续无法解释结果差异,也无法按类型单独分析。
评价口径要写死
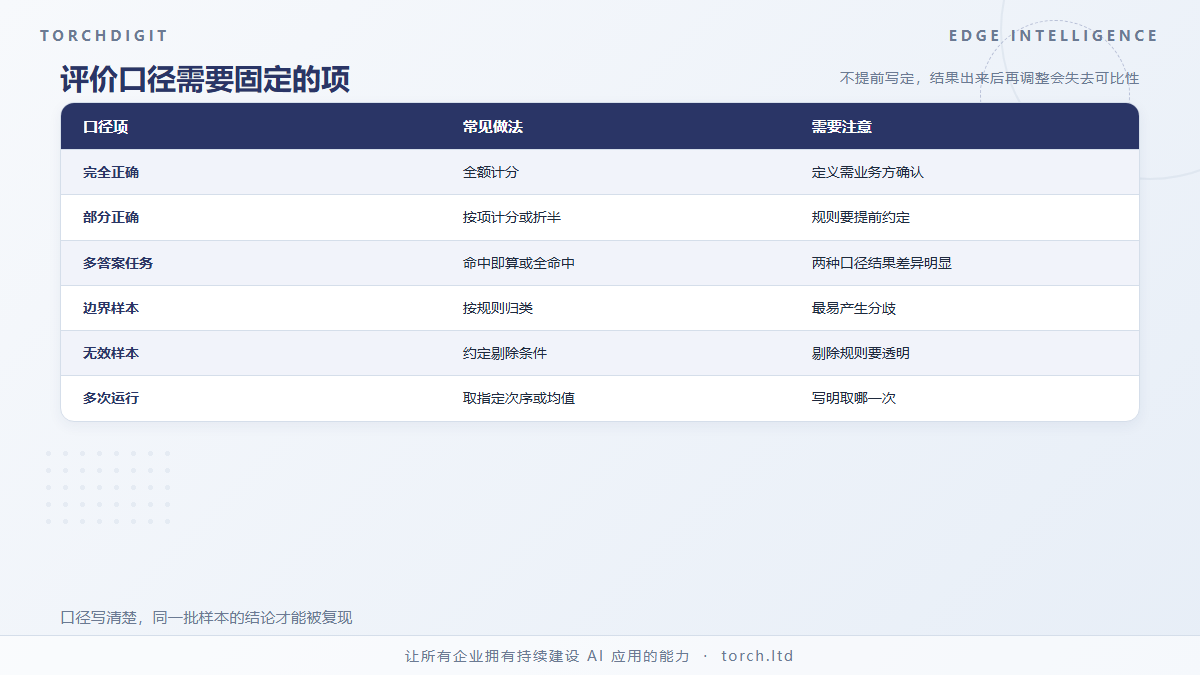
评价口径包括计分方式、边界判定与统计规则,这些内容需要在测试前固定,避免结果出来后调整。
计分方面,需要明确完全正确、部分正确与错误各自的处理方式。多答案任务尤其需要约定:命中一个算对,还是要求全部命中。
边界判定方面,正确与错误之间的中间状态如何归类,是争议最集中的地方。可行的做法是设定明确的判定规则,并由业务方确认,而不是交由评价者临场判断。
统计方面,需要约定是否分层报告、是否剔除无效样本、多次运行取哪一次结果。这些规则写清楚,测试结论才能被复现。