长上下文在端侧的内存账怎么算:权重与 KV Cache 的估算方法
端侧部署长上下文,最先撞上的往往不是算力,是内存。算力决定生成快不快,内存决定模型装不装得下、上下文能开多长、同时接几路请求。上下文一长,KV Cache 随长度增长,内存先于算力成为瓶颈,把这两笔账分开算,设备才选得准。
内存由两笔账构成:权重与 KV Cache
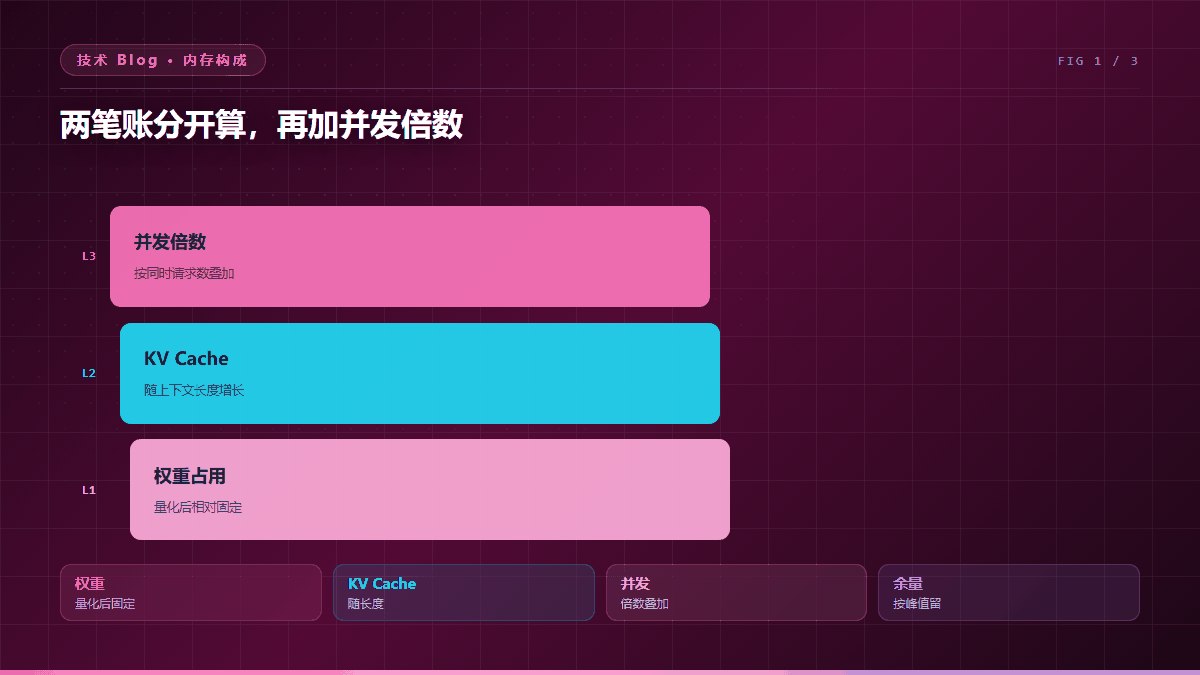
设备内存里,模型相关的占用分两块。一块是权重,模型参数本身的存储,量化之后相对固定,不随输入变化。另一块是 KV Cache,推理时为已处理的 token 保留注意力键值,随上下文长度逐位增长,随并发路数成倍叠加。
两笔账的性质不同。权重是一次性占用,装进内存就固定下来;KV Cache 是运行中动态增长,峰值出现在最长上下文、最高并发的时刻。估算设备能否承载,按两笔账的峰值之和算,不按权重的固定值算。
两笔账各自怎么估
两笔账的估算方式各不相同,受影响的变量也不一样。
| 项 | 估算方式 | 受什么影响 |
|---|---|---|
| 权重占用 | 参数量乘位宽,再除以八,按量化后的位宽计 | 参数档位与量化位宽 |
| KV Cache | 层数乘头数乘头维度乘二,再乘序列长度与并发,按缓存位宽计 | 上下文长度、并发路数、缓存位宽 |
| 运行时与驱动 | 按平台固定量预留,单独出一项 | 运行时实现与推理后端 |
权重那笔账好算,量化方案一定,数字就定了。KV Cache 那笔账跟着业务场景走:上下文开到多长、同时接几路,两个变量一放大,缓存占用按乘积上升。运行时与驱动的固定占用单列一项,估算时不会漏掉。
估算落到具体设备时,把已知的三项先填上:参数档位与量化位宽填权重那一行,层数、头数与头维度填 KV Cache 那一行,系数按缓存位宽对齐。
三项齐了,剩下能动的只有上下文长度与并发路数,占用随这两个变量变化,估出来的是一条随长度上升的曲线,不是一个固定值。
上下文长度与并发怎么共同推高占用
KV Cache 的占用与上下文长度成正比,与并发路数也成正比。两个变量相乘,放大效应比单独看其中任何一个都大。上下文开一倍、并发加一路,缓存占用翻的不是一倍两倍。
业务里的峰值常同时落在两个变量上:一批请求集中到达,每路输入又都是长文档。估算按这个最忙时段取值,把并发路数与最长上下文放在一起算,得出的缓存占用才是设备要留住的量。
分路之后占用更清楚。短任务与长任务分开跑,短任务用小上下文,长任务单独一路,缓存占用各按自己的长度算,总量比全部按最长上下文预留要省。
量化对两笔账的差别
量化对两笔账的作用不一样。权重那笔账,量化直接压位宽,占用随位宽下降,压得动。KV Cache 那笔账,量化要专门对缓存做处理,缓存位宽降下来,占用跟着降,但缓存里的数值对精度更敏感,量化方案要单独校准。
两者的收益不同步。权重从高位宽压到低位宽,省下的是固定占用,一次性兑现。缓存压位宽省下的是动态占用,随上下文长度放大,长上下文下收益更明显。两笔账分别定量化方案,比一套方案套到底更省内存。
两笔账的分工也定下了优化的顺序。内存吃紧时先看权重能不能再压一档,权重压完仍紧的,再动缓存的位宽与分路策略。顺序不反着走:权重先省下的是固定占用,稳住底盘;缓存后调的是动态占用,跟着业务场景走。
怎么留余量
- 按峰值预留。按最长上下文与最高并发同时出现的最忙时段取值,不用平均值。
- 权重与缓存分开留。权重按固定值加运行时的量留,缓存在峰值基础上往上取一档,给上下文临时增长留空间。
- 按场景分路。短任务与长任务分路跑,各自按自己的长度分配缓存,不把最长上下文的占用摊到每一路。
三条原则合起来是一句话:先按峰值算总额,再按场景分路把峰值拆开。设备内存按总额选,运行时的实际占用靠分路压下来,长上下文就落得进设备。
常见问题
问:长上下文要把内存一直留到最大吗?
按业务里的最长上下文与最高并发一起算峰值,再按场景分路把峰值拆开。短任务与长任务分路,各自按自己的长度分配,总额按峰值预留,实际占用由分路压下来。
问:缓存量化会不会影响输出?
缓存量化单独校准,按任务对精度的敏感度定方案。对数值敏感的层缓存保持较高位宽,对数值不敏感的层缓存压位宽,两笔账分开权衡。
问:权重和缓存哪个先省?
先省权重。权重是固定占用,量化一次压下去就兑现;缓存按业务场景调,靠上下文长度与并发的取值把占用控住。两笔账一起算,内存才估得准。
长上下文的内存账,是把权重与 KV Cache 分开算,再加并发倍数。炬擎数原(TORCHDIGIT)在端侧推理链路上提供炬焰推理引擎与端侧模型系列,权重与缓存的分项估算沿这条链路一并落地。以上内容仅供参考。