端侧设备连续运行的稳定性怎么验证:该记哪些日志、记多久
端侧设备部署之后多为无人值守,一次压测只能说明当下的状态。稳定性是长期跑出来的:被动散热的温升、供电的波动、存储的写满,都可能在某一天显现。要验证稳定性,靠的是日志与长跑——日志记录发生了什么,长跑把时间拉长到足以暴露问题。
为什么稳定性要靠日志和长跑
稳定性问题的特点是低频、迟发。它在短测里不出现,在连续运行大量任务之后出现;在空载状态不出现,在跑满真实数据之后出现。这类问题没有日志就无从定位,没有长跑就根本看不到。
端侧还有一个绕不开的条件。设备在现场,没有开发环境,问题发生时的现场状态留不住,事后能依靠的只有当时写下的日志。日志写到什么程度,决定了复盘能走多深。
稳定性验证的另一半是长跑。端侧设备的失效多与运行时长相关:散热积灰、电源老化、存储碎片,这些因素随时间累积。验证要把时间维度纳入进来,让设备在真实负载下连续运行,观察它在不同时段的表现是否一致。
该记哪几类日志
日志分四类,各有各的用途,缺一类就会在某一类问题上失明。
| 类别 | 记什么 | 频率 | 保留时长 |
|---|---|---|---|
| 运行日志 | 启动、健康状态、任务进出 | 每次启动与定时心跳 | 明细滚动保留,留最近一段 |
| 性能日志 | 单次任务耗时、资源占用 | 每个任务记录 | 明细按周汇总,汇总值长期留 |
| 异常日志 | 报错、崩溃、重启与恢复 | 触发即记 | 长期保留,故障追溯依据 |
| 事件日志 | 升级、配置变更、规则下发 | 变更即记 | 与版本共存,长期保留 |
四类里,异常日志与事件日志不轻易删。异常日志是故障追溯的唯一依据,事件日志用来回答「问题出现在哪个版本之后」。运行日志与性能日志的明细滚动轮转,汇总值保留,空间与信息量在这里取得平衡。
字段方面,每条日志除了内容本身,时间戳、任务编号与版本号三项要带全。时间戳用于对齐时间窗,任务编号用于串起一次任务的各阶段,版本号用于回答「问题出现在哪个版本之后」。三项齐了,日志才能被拼回一条完整链路。
记录频率与保留时长怎么定
频率与时长由用途反推,不按感觉定。
用于定位的日志记细一些、频率高一些,字段完整到能还原一次任务的全过程,从输入、各阶段耗时到资源占用,缺一段就断一次定位。用于追溯的日志长期保留,宁可占空间也不丢内容。
存储有限时靠分级与轮转腾空间:明细滚动、汇总常留,必要字段常驻,明细分级保留。分级之后,关键信息不受容量影响,长期可用。
还要区分稳态与变更期。稳态运行的记录频率保持恒定,便于长期对比;版本变更前后的一段加密切记,把变更前后的状态都留在日志里。变更期数据加密之后,对比前后差异才有依据。
长跑怎么设计
长跑按三条原则设计。
第一,覆盖真实工况。跑真实任务、真实并发与真实数据量,空载长跑停留在设备空转,业务中的表现要在真实负载下才看得到。
第二,覆盖温升与峰值。从冷启动跑到热稳定,再叠加业务高峰。被动散热的设备,热稳定之后的表现在实测中最关键,也最容易被忽略。
第三,长跑期间保持日志完整。长跑本身也是采样过程,日志断了一段,对应的那段结论就无从给出。
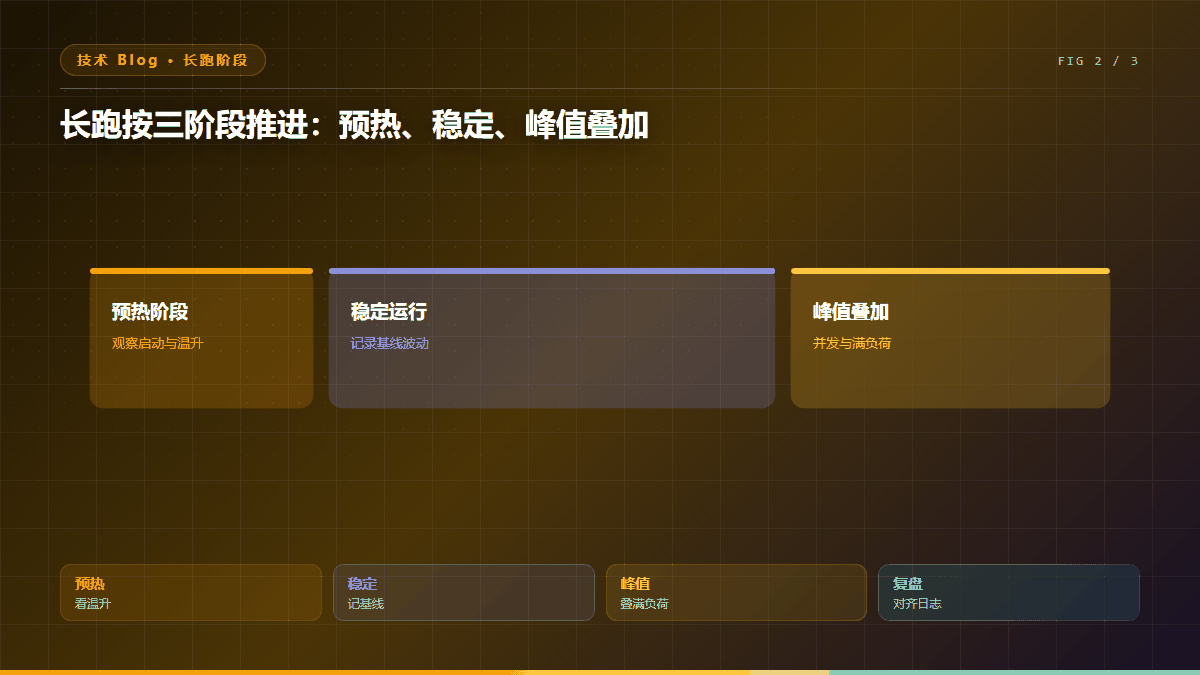
长跑分三个阶段推进:预热阶段观察启动与温升,稳定运行阶段记录基线波动,峰值叠加阶段把并发与满负荷加上去。三个阶段各自记各自的日志,最后对齐看。
异常怎么复盘
复盘按四步走,每一步都落在日志上。
- 对齐时间窗。用日志把异常前后一段时间对齐,连同环境与供电的记录一起看,先确定异常发生的准确时刻。
- 看恢复路径。判断是自动恢复还是需要重启,恢复之后是否回到基线,这一步决定问题的严重程度。
- 定触发条件。把触发条件写成可复现的最小组合——什么输入、什么并发、什么温度下出现。
- 留版本与结论。记录异常出现在哪个固件、模型与配置版本,结论归档,避免以后重复排查同一个问题。
四步跑完,一次异常就变成文档里的一个条目。条目里写清现象、触发条件、版本范围与处置动作,下次遇到同样现象直接对照。条目积累多了,就形成这台设备自己的异常库,后来者照着查,不必从头试起。
常见问题
问:日志要记多少算够?
以能定位为准。判断标准是一次故障发生时,日志能不能支撑起上面的四步复盘。异常与事件两类必须留全。
问:长跑要跑多久?
覆盖一次完整的温升过程与一次业务高峰。跑到基线出现可观测的波动为止,这段时间由设备与工况决定。
问:只跑一次长跑就够吗?
每次固件、模型或配置变更之后重跑一轮。日志口径保持不变,前后两轮才能对比,变更带来的影响才看得出来。
端侧稳定性靠日志与长跑验证,口径统一才能长期对比。炬擎数原(TORCHDIGIT)在端侧链路上提供炬核 AgentOS 运行时与炬焰推理引擎,日志分级与长跑设计按本文清单执行落地。以上内容仅供参考。