端侧模型吞吐怎么测:一套可复现的评测口径
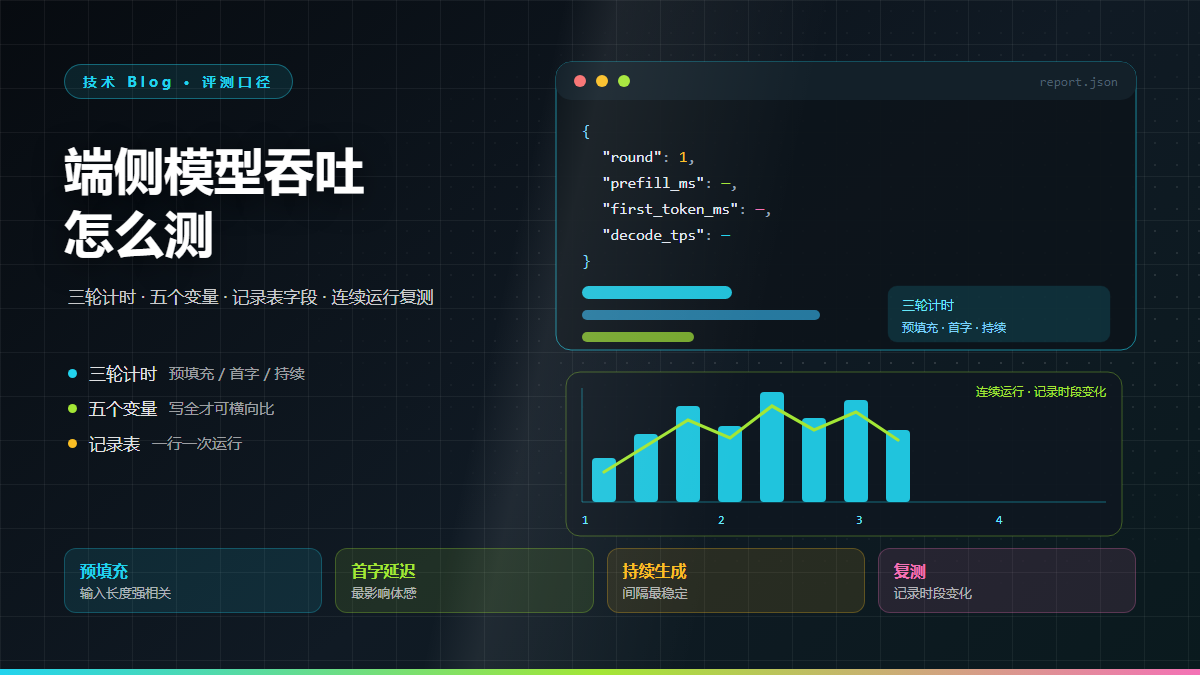
端侧模型的吞吐评测,指在固定硬件、固定量化方案、固定输入输出长度的前提下,测量单位时间能生成多少 token。这个数只有在条件写全时才可比,单独报一个数字没有意义。
为什么现成的吞吐数字不可比
同一个模型,换三套测法能得出差几倍的结果。常见的情况有三种。
第一种是只报峰值。厂商给出的数字往往是空载、单请求、理想输入长度下的最好成绩,实际业务里同时有五六个请求排队,吞吐会明显下降。
第二种是拿不同条件的结果并列。一边是 int8 量化、短输入,一边是 fp16、长上下文,两个数字放在一张表里,看上去是产品差距,其实是测试条件差距。
第三种是只报吞吐不报延迟。吞吐高不等于体验好,首字返回时间过长,用户会认为系统卡住。真正需要一起看的是三个量:首字延迟、单请求生成速度、并发下的总吞吐。
报告里要写全的五个变量
要让一次评测可复现,下面五项要在报告里写全,结果才便于横向比较。
| 变量 | 为什么要固定 | 怎么写进报告 |
|---|---|---|
| 硬件平台 | CPU 与 NPU 上跑同一模型,结果不在一个量级 | 芯片型号、核心数、内存容量与频率 |
| 量化方案 | 位宽直接决定速度与内存,两套方案不可混比 | 位宽、量化方式、校准集规模 |
| 输入长度 | 预填充阶段的耗时随输入长度非线性增长 | 固定档位,如 256/1024/4096 token |
| 输出长度 | 生成阶段速度稳定,累计耗时仍随长度线性增长 | 固定生成上限,并记录实际生成长度 |
| 并发数 | 单请求与多请求是两种场景,指标含义不同 | 分别报 1 并发与目标并发两档 |
测什么:三段拆开记
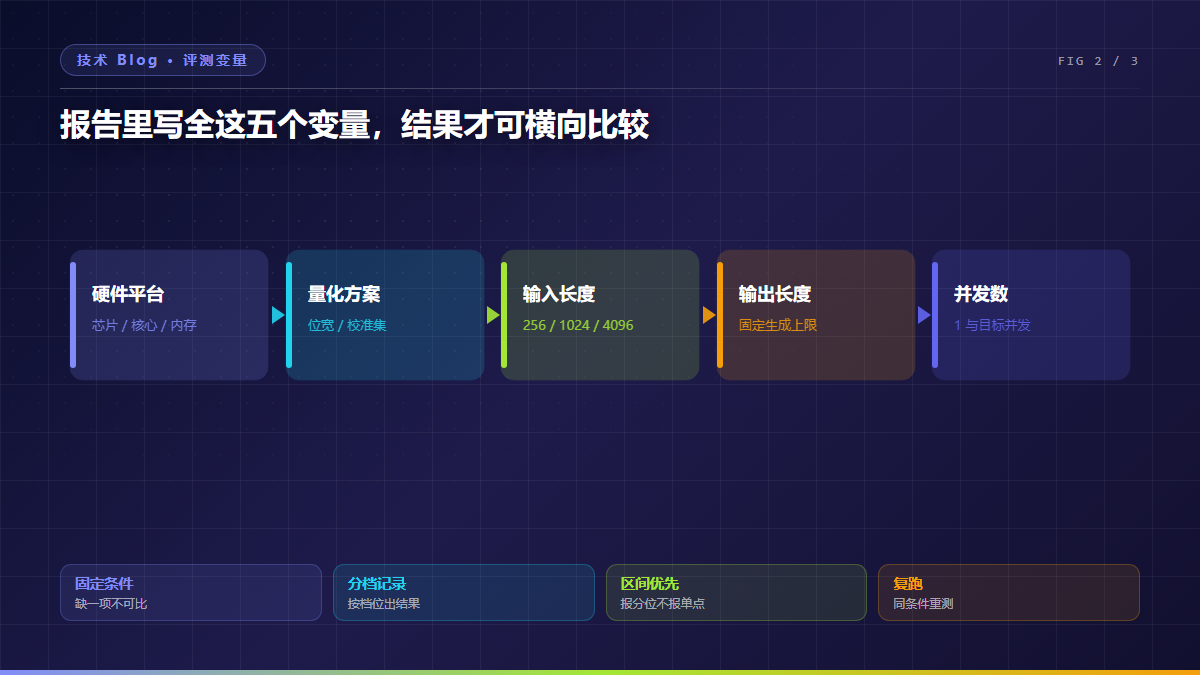
一次推理拆成三段记录,比只看总数有用。
第一段是预填充,把输入吃进模型并建立缓存,耗时与输入长度强相关。第二段是首字生成,从缓存建立完成到第一个 token 输出,这一段最影响体感。第三段是持续生成,之后每个 token 的间隔,这一段最稳定。
分开记的好处是定位问题。首字慢,问题多在预填充或调度;持续生成慢,问题多在算力或量化方案。总量低但两段都正常,那要看是不是并发一上来就被抢占。
记录表长什么样
每次评测至少落一张表,一行一次运行。字段如下。
| 字段 | 单位 | 用途 |
|---|---|---|
| 用例编号 | — | 与样本集对应,便于复跑 |
| 输入 token 数 | token | 区分预填充档位 |
| 首字延迟 | 毫秒 | 体感指标 |
| 生成速度 | token/秒 | 核心吞吐指标 |
| 峰值内存 | MB | 判断能否落在设备内存内 |
| 环境温度 | ℃ | 端侧设备常无主动散热,温升会降频 |
结论怎么下
三条原则。
一是只在同条件内比较。改动任何一项变量,都要重测,不能拿旧数据对照。
二是报区间不报单点。同一用例跑多轮取分位数,比报一个最好值更接近真实。
三是把适用范围写出来。说明在什么输入长度、什么并发下结果开始变化,比给一个均值有用。
常见问题
问:样本集要多大?
覆盖业务里的典型输入长度分布即可,每个档位不少于二十条。样本要能复跑,不能每次换一批。
问:要不要测长上下文?
要。长输入下预填充占比大幅上升,是端侧最容易出问题的一段。至少测一个接近业务上限的档位。
问:端侧设备连续跑几小时,结果还准吗?
被动散热的设备跑久会降频,评测里要加一轮连续运行,记录不同时段的数值变化。稳定性怎么验证另见专门一篇。
端侧评测的口径统一,是部署前最容易省、也最不该省的一步。炬擎数原在端侧推理链路上提供炬焰推理引擎与端侧模型系列,评测模板与样本集的组织方式可参照本文的变量清单执行。以上内容仅供参考。