量化前后精度怎么比:三类任务的评测流程与判定线
量化几乎一定会让精度掉一点,关键是怎么把这点损失量出来。量化前后的精度对比,按任务分三类来看,三类的主指标、判定线与复核方式各不相同,混在一起看就会失真。
为什么单一总分不可用
把三类任务混成一个总分,看上去简洁,实际没有指导意义。判别错一个与抽错一个字段,代价完全不同;生成任务的质量更没有统一尺度,覆盖率高的答复可能关键信息缺失,措辞流畅的可能结论偏移。
单一总分还会掩盖损失分布。整体只掉一点,可能集中在某一类任务、某一类样本上,甚至集中在最需要准的那一类上。平均值把这些差异抹平,上线之后才会暴露出来。
还有一种情况是把不同条件的结果并列。一边是高位宽量化、短输入,一边是低位宽、长上下文,两个数字放进一张表,看上去是方案差距,其实是测试条件差距。对比的前提,是同一样本、同一硬件、同一推理参数。
三类任务各看什么指标
按任务类型拆开,每类配一套主指标、判定线与复核方式。
| 任务类型 | 主指标 | 判定线 | 样本量 | 复核方式 |
|---|---|---|---|---|
| 判别类(分类、判定、检出) | 准确率与漏检率 | 相对下降设线,漏检率另设绝对下限 | 覆盖全部类别,长尾类单独凑够 | 人工抽检错分样本 |
| 抽取类(字段抽取、结构化) | 字段级完全匹配率 | 按字段设线,关键字段单独设线 | 覆盖各版式与非标件 | 与原始材料逐字段对照 |
| 生成类(摘要、问答、改写) | 关键信息覆盖率与人工评分 | 覆盖率相对下降设线,评分设下限 | 覆盖典型与复杂输入 | 人工双评,取双方一致部分 |
三类的判定线口径也不同。判别类与抽取类看的是「准不准」,判定线落在错分与漏抽上;生成类看的是「全不全」,判定线落在关键信息有没有覆盖上。拿同一套判定线套三类,等于用一把尺子量三种东西。
评测流程五步
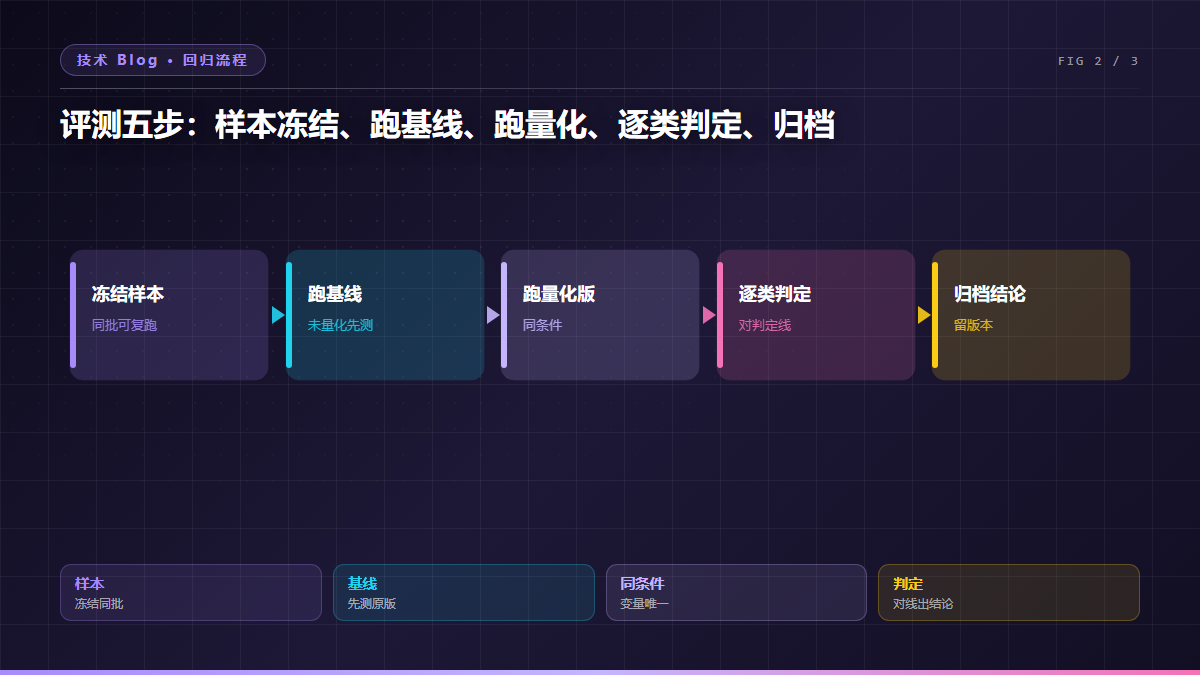
流程固定下来,每次量化照走一遍,结果才能前后对照。
- 冻结样本。把评测样本定下来,类别、样式、长度分布固定,整批可复跑,不随批次更换。
- 跑基线。量化前先在原版模型上跑一遍,得到各类指标基线,作为对照的起点。
- 跑量化版。同一样本、同一硬件、同一推理参数下跑量化模型,只让量化这一个变量变化。
- 逐类判定。三类分开对判定线,判出通过或不通过,不合并成一个总分。
- 归档结论。把样本版本、量化方案、各项指标与结论一并归档,作为下一次对比的依据。
判定线怎么定
判定线用两层来定。第一层是相对下降,同一指标量化后相对基线下降的幅度设一条线,降幅在这条线内才算通过。第二层是绝对下限,某些指标在业务上有一条不能跌破的底线,比如漏检率,单独再设一条绝对值下限。
两层同时满足才算通过。只看相对下降,基线本身偏低时会放行;只看绝对下限,基线高时又过于宽松。两层叠加,既守住底线,也保持前后可比。
两层线的值从业务里来,不从数字里凑。漏检率的下限由业务能承受多少漏放决定,相对下降的幅度由这一版量化的目标决定。线定下来写进评测报告,下一版量化照着同一条线判。
改量化就要重测:回归与上线
量化方案一变,量化前的那份结论就不再适用。改位宽、换量化方式、换校准集,都要在同一批冻结样本上重跑五步流程,得出新结论再上线。
上线之后保留回归。每次模型更新或推理后端升级,都拉同一批样本复跑,指标偏离判定线即回退。把评测脚本和样本一起纳入版本管理,回归随时能重来。
常见问题
问:三类任务的指标能求平均吗?
三类代价不同、尺度不同,合在一起只会互相掩盖。要看的是每一类是否都过线,三类各自过线,才算整体通过。
问:样本量要多大?
覆盖业务里的典型类别与长尾类别,长尾类单独凑够数量。样本整批可复跑,不随批次更换;样本一旦定下,跨版本保持不变,出的结论才可比。
问:量化后掉分就换方案吗?
先看掉在哪一类、掉多少。相对下降在设线内、绝对下限没跌破,方案保留;跌破下限的那一类,单独调量化方式,或对该类任务单独处置,调过之后在同一批样本上复跑,重新对线。
量化前后比精度,比的是一个可复跑、可对照的评测过程,不是一个孤立的分数。炬擎数原(TORCHDIGIT)在端侧推理链路上提供炬焰推理引擎与端侧模型系列,量化与评测的口径可参照本文的三类指标清单执行。以上内容仅供参考。