int4 量化后 1GB 常驻:端侧部署的内存账怎么算
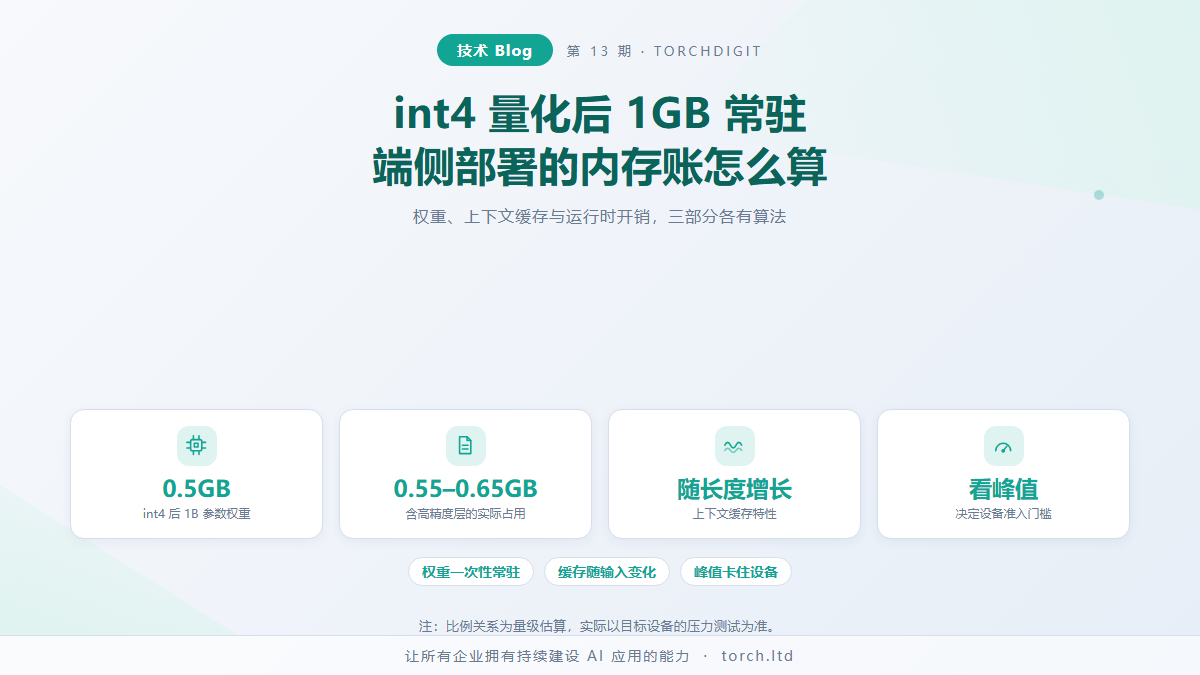
内存是端侧部署最先撞到的那堵墙。设备的内存预算不会因为要跑 AI 而增加,模型必须先算清自己能占多少,再倒推以什么规格运行。把「1GB 常驻」这句话拆开,它由三部分构成:权重、上下文缓存、运行时开销。三部分各占多少、哪些压得动、哪些压不动,直接决定了这套模型能落在什么设备上。
第一部分:权重占用
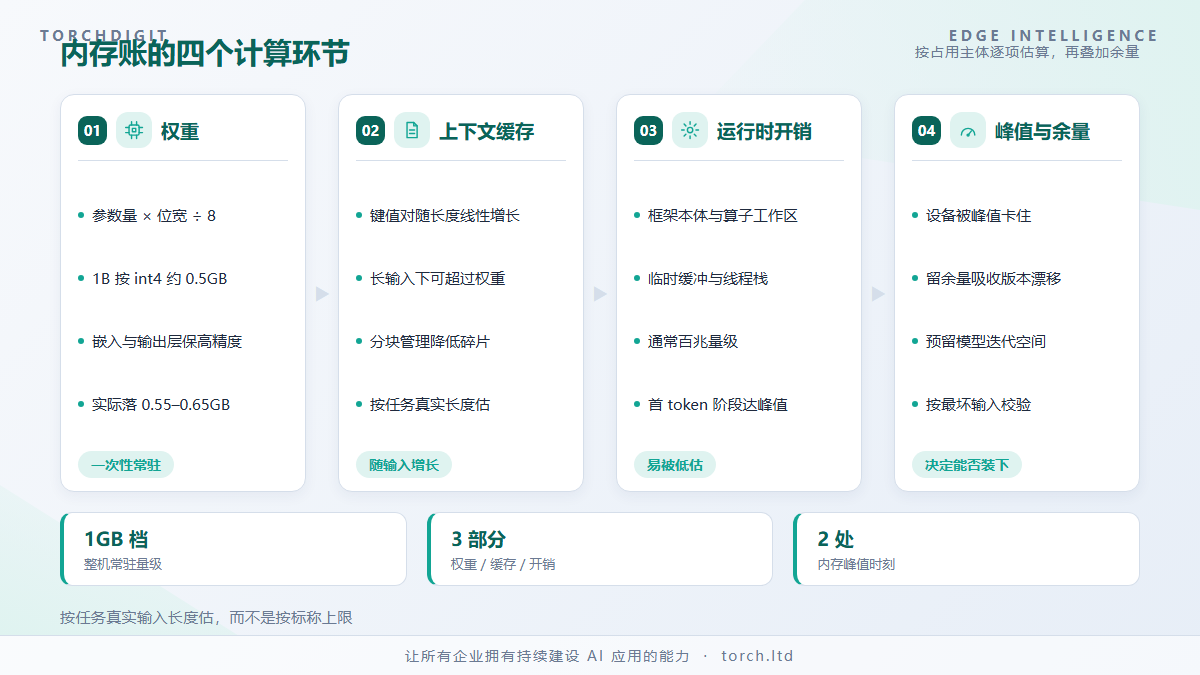
权重是账面上最好算的一块。参数量乘以位宽再除以 8,就是理论占用:1B 参数按 int4 存储约 0.5GB,同样参数按 int8 存储要 1GB,按 16 位浮点则要 2GB。位宽每降一级,占用减半。
实际占用会略高于理论值,原因是并非所有层都适合压到同一精度。嵌入层与输出层通常保留 8 位或更高精度,因为这两处直接对应词表,量化误差会放大成明显的用词偏差。按经验,权重部分最终落在 0.55GB 到 0.65GB 之间比较常见。
权重属于一次性常驻,模型加载完成后大小固定,不随输入变化。这部分决定了设备的准入门槛。
第二部分:上下文缓存
上下文缓存是随输入增长的部分,也是最容易被低估的部分。自回归解码时,每一层的键值对都要保留下来供后续 token 复用,占用与序列长度成正比。上下文越长,缓存越大。
以一个 1B 规格、支持 128K 上下文的模型为例,缓存峰值会显著超过权重本身。这解释了一个常见现象:模型标称支持长上下文,但设备上实际能稳定处理的文本长度要低得多。可用的做法包括分块管理缓存、对历史段落做压缩摘要、以及按任务类型限制单次输入长度。
对多数企业任务而言,输入并不是越长越好。单据字段抽取、工单分类这类任务,输入通常在几百 token 内,缓存压力很小;长文档问答才会把这块推成瓶颈。因此在算账时,应该按业务任务的真实输入长度分布来估,而不是按模型标称上限来估。
第三部分:运行时开销
运行时开销包括推理框架本体、算子工作区、临时缓冲区以及并行线程栈。这部分常被忽略,却往往决定了「能不能装进去」的最后一两百兆。
不同框架的基线开销差异不小,轻量实现可以压到几百兆以内,功能完整的运行时则更高。峰值内存通常出现在两个时刻:模型加载完成的瞬间,以及生成第一个 token 的阶段——此时权重、缓存与算子工作区同时驻留。选型评估时应该看峰值而不是均值,因为设备是被峰值卡住的。