无 GPU 的 4 核 ARM 网关跑出 63 tok/s 意味着什么
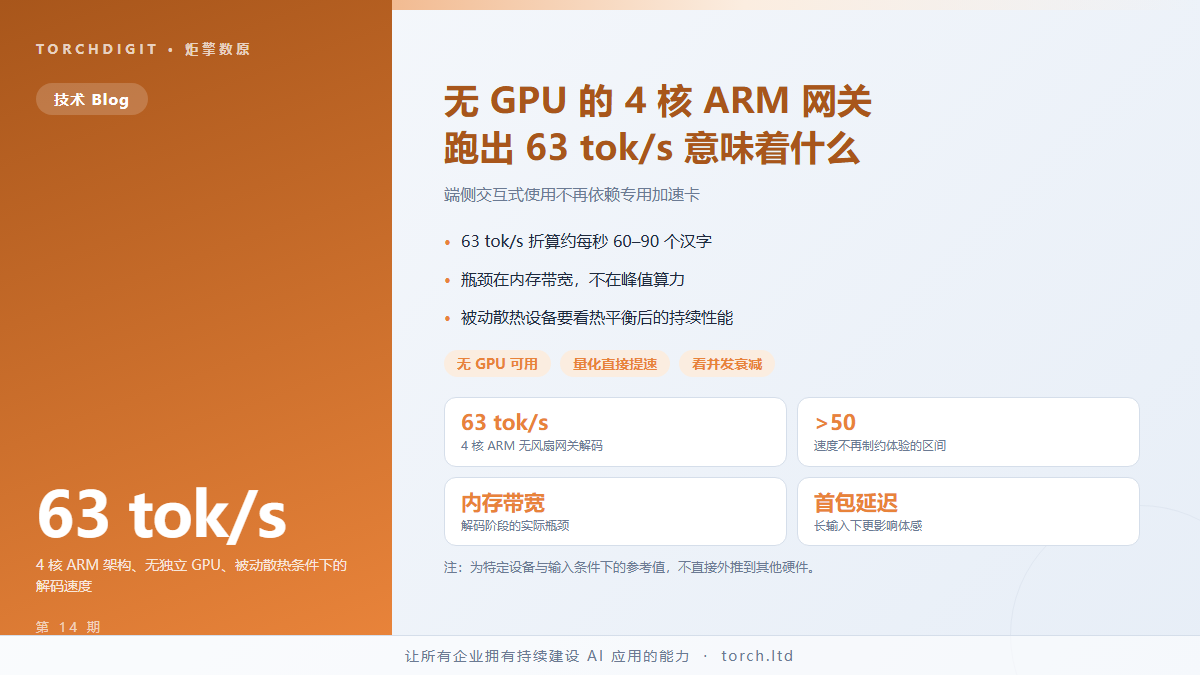
一台没有独立 GPU、靠被动散热工作的 4 核 ARM 工业网关,把 1B 参数模型的解码速度做到 63 tok/s。这个数字的意义不在于刷新纪录,而在于它把端侧部署的设备门槛拉到了工控机与网关这一档——不需要专用加速卡,现场既有设备就能承载。要判断这个数字能支撑什么业务,需要先看懂它处在什么量级,以及瓶颈究竟在哪。
63 tok/s 对应什么体验
解码速度直接决定用户的等待感受。中文语境下,一个 token 大致对应一到两个汉字,63 tok/s 折算下来接近每秒 60 到 90 个汉字的输出速度,比正常阅读速度快得多,也比多数人的打字速度快。
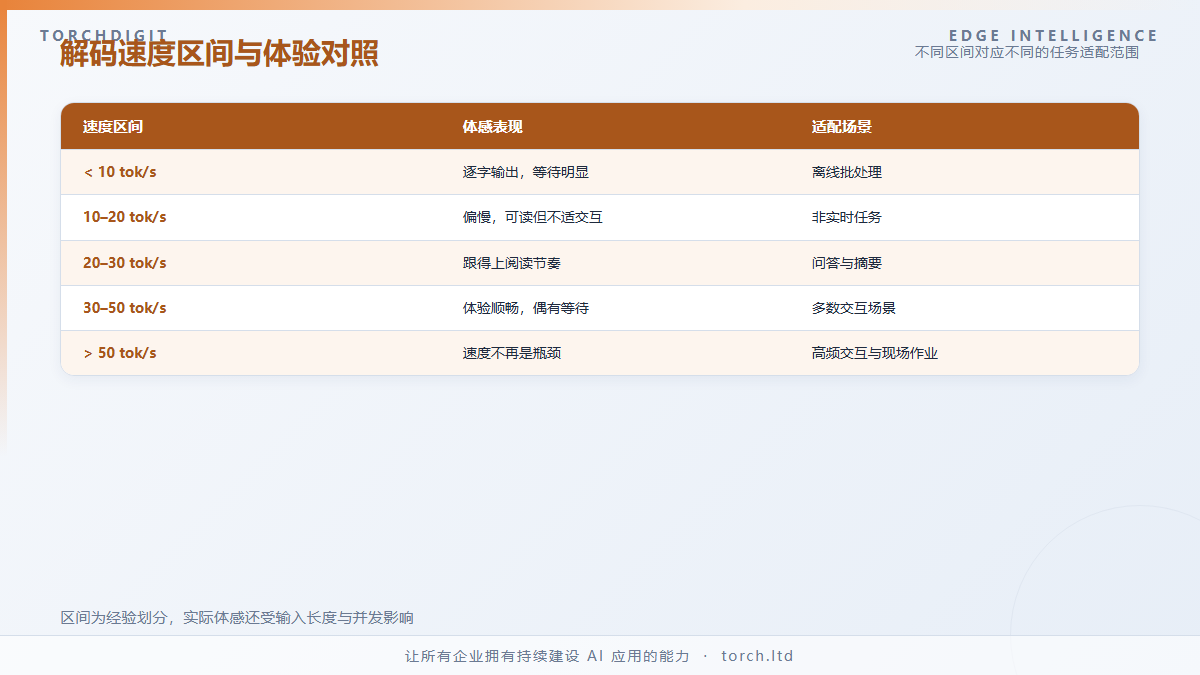
参考几个常见区间:低于 10 tok/s 时,输出会一个字一个字往外蹦,用户能明显感到等待;20 到 30 tok/s 达到「跟得上读」的水平;超过 50 tok/s,输出速度已经不再是体验瓶颈,用户的注意力会回到内容本身。63 tok/s 落在这个区间,意味着交互式使用是成立的。
需要区分的是首 token 延迟与解码速度。前者是用户按下回车到看见第一个字的时间,由输入长度决定;后者是后续 token 的生成速度。长输入场景下,首 token 延迟往往比解码速度更影响体感。
瓶颈不在算力,在内存带宽
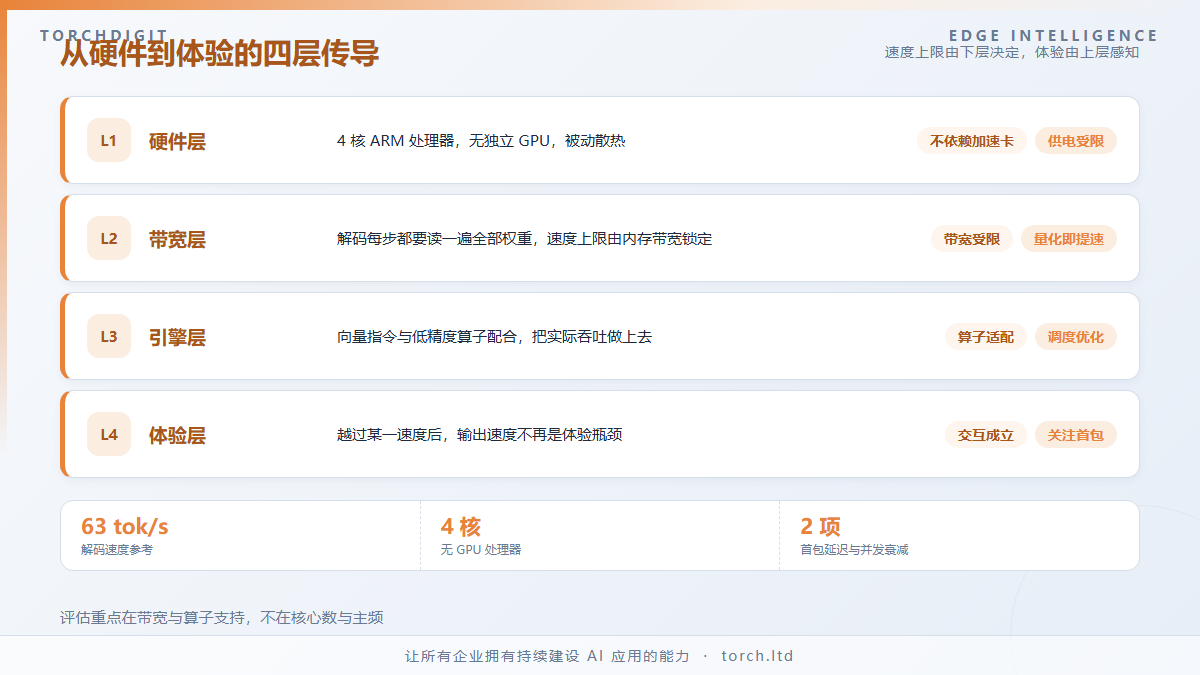
没有 GPU 还能跑到这个速度,原因在于解码阶段的瓶颈性质。自回归解码每生成一个 token,都要把所有模型权重从内存读一遍。这个阶段的计算量不大,但数据搬运量大,实际速度上限由内存带宽而非峰值算力决定。
这也解释了为什么量化对速度的贡献如此直接。权重从 16 位压到 int4,需要搬运的数据量降到约四分之一,在带宽受限的场景下,速度提升幅度往往接近这个比例。ARM 架构处理器普遍配有向量指令与矩阵运算扩展,配合量化后的低精度算子,能在不依赖 GPU 的情况下把吞吐做上来。
因此这类设备的性能评估,应该重点看内存带宽与量化算子支持,而不是只看核心数与主频。
这个数字应该怎么用
63 tok/s 是一条基准线,不是所有任务都能达到的保证值。它通常在固定输入长度、指定模型规格与特定框架配置下测得。输入变长、上下文堆积、并发请求增加,实际速度都会下降。
把这条基准线放进业务判断,能得到比较清楚的结论:高频短输入的任务,比如字段抽取、分类打标、告警摘要,速度完全够用;需要长上下文推理或批量处理的场景,则应该评估并发下的速度衰减。设备选型时,更实用的做法是拿真实业务输入在目标设备上测一轮,观察速度随负载变化的情况。