128K 上下文在端侧设备上如何不爆内存
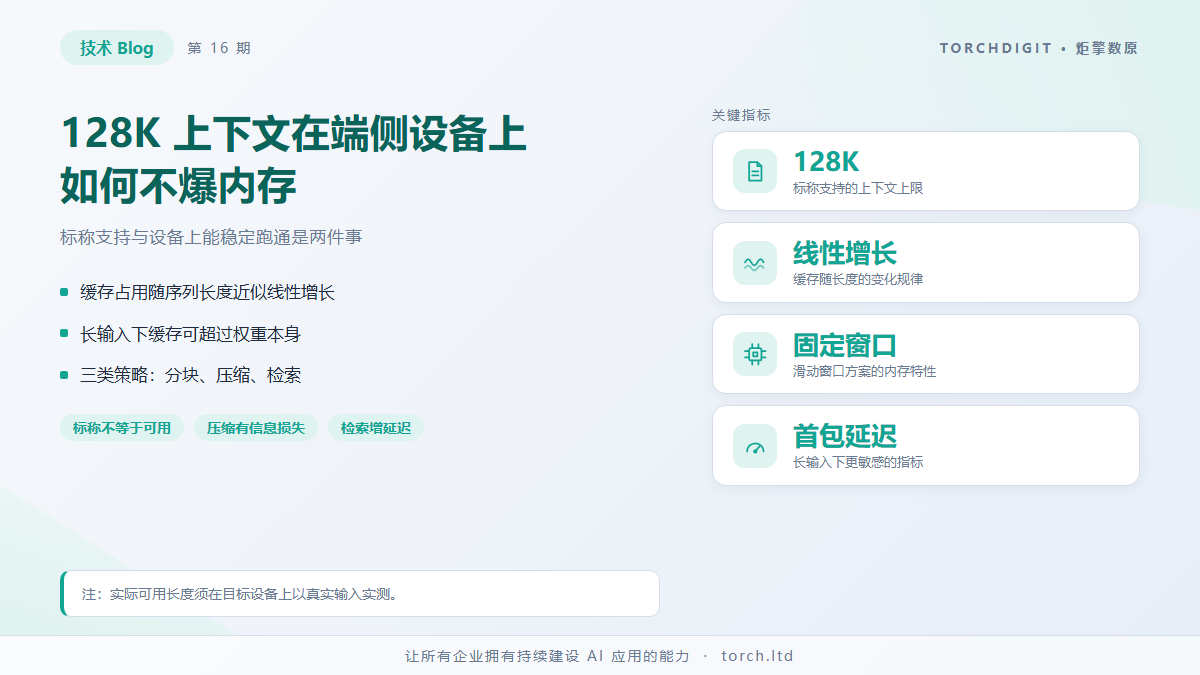
长上下文是端侧模型近两年进步最明显的一项能力,128K 量级的上下文窗口已经出现在 1B 规格的模型上。但标称支持与设备上能稳定跑通是两件事。上下文越长,推理过程需要保留的中间状态越多,内存占用随长度近似线性增长。在内存只有几 GB 的设备上,长上下文的工程重点不是「能不能读这么长」,而是「读了之后还撑不撑得住」。
代价:缓存随长度线性增长
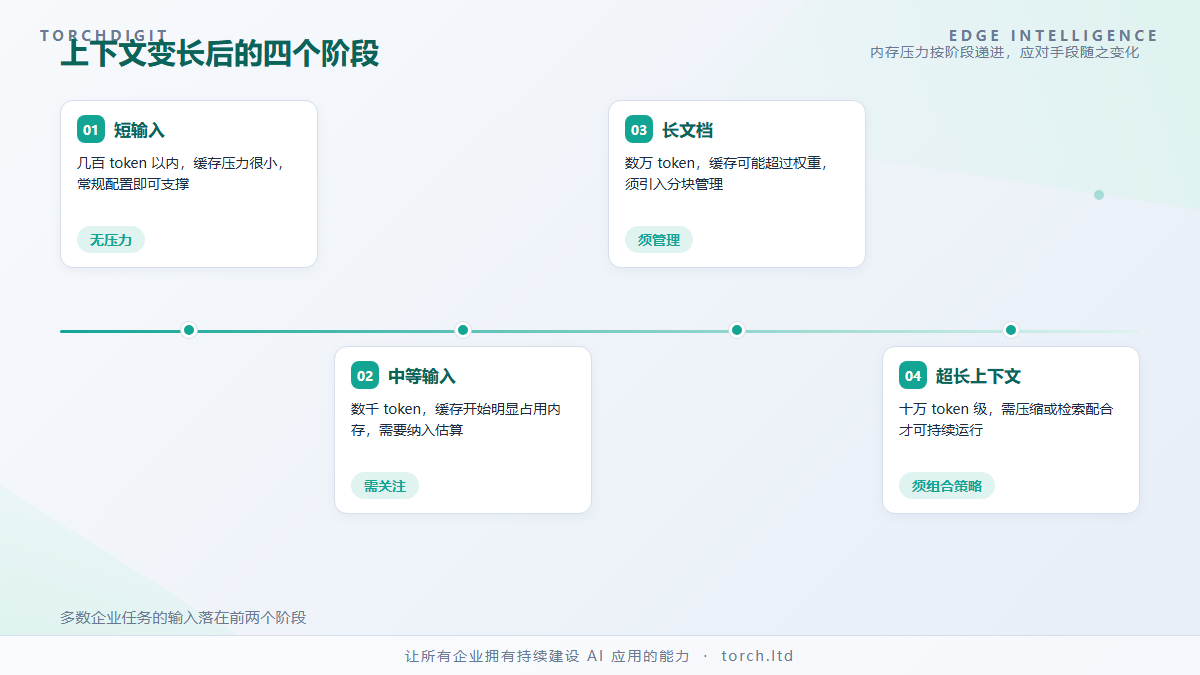
自回归解码时,每一层注意力都需要保留历史 token 的键值对,供后续 token 复用。这份缓存的大小与序列长度成正比,与层数和隐藏维度也相关。输入从 8K 增长到 128K,缓存占用增长约十六倍,很快就会超过权重本身。
这也是端侧长上下文与云端长上下文的关键差别。云端可以靠更大显存和更激进的调度来吸收这部分开销,端侧设备的余量有限,必须从算法和调度两侧同时压缩。
值得注意的是,缓存增长并不是均匀的。对话早期写入的内容在后续解码中占比很小,但仍然占据内存。这部分冗余是优化的主要目标。
策略:从缓存管理入手
常见的应对手段有三类。
第一类是分块管理,把缓存切成固定大小的块按需分配,避免为了可能的长度预留整块连续内存。这在内存碎片较多的设备上收益明显。
第二类是压缩历史,对较早的上下文做摘要或降采样,保留语义要点而丢弃逐字原文。这种方式带来信息损失,需要评估对业务精度的实际影响。
第三类是滑动窗口加外部检索,只把最近一段完整保留在缓存中,更早的内容转存到本地向量库,需要时再取回。这种方式把内存压力从「随长度增长」变成「随窗口固定」,代价是引入了检索环节与相应的延迟。
三类策略可以组合使用。选择哪一类,取决于业务对「是否必须逐字保留上下文」的要求有多硬。
落到业务:按任务定长度
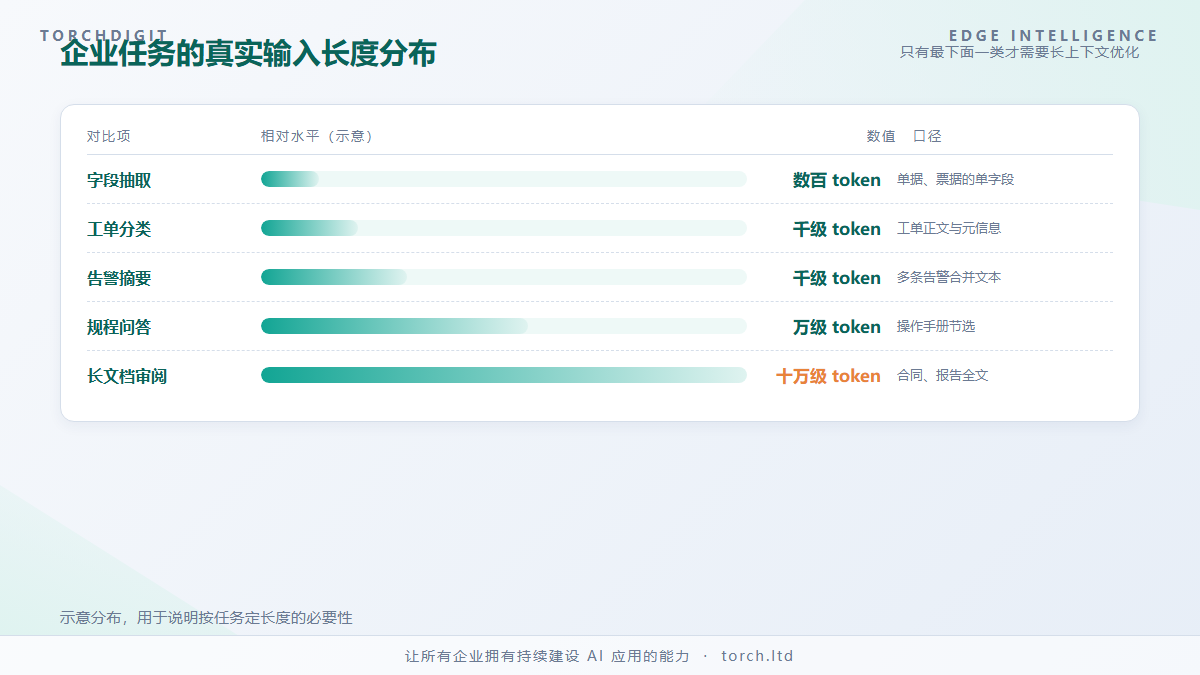
实际部署中,最有效的优化往往不是技术层面的,而是把任务输入长度定在合理范围。企业高频任务大多不需要长上下文:单据字段抽取、工单分类、告警摘要,输入通常在几百到几千 token。真正需要长上下文的是长文档问答、合同审阅、多轮长会话这几类。
对这两类任务应采用不同的配置:短输入任务限制单次长度,把内存余量留给并发;长文档任务则接受较低并发,并配合分块或检索策略。把两类任务混在同一设备上不加区分,很容易出现「短任务被长任务拖垮」的情况。