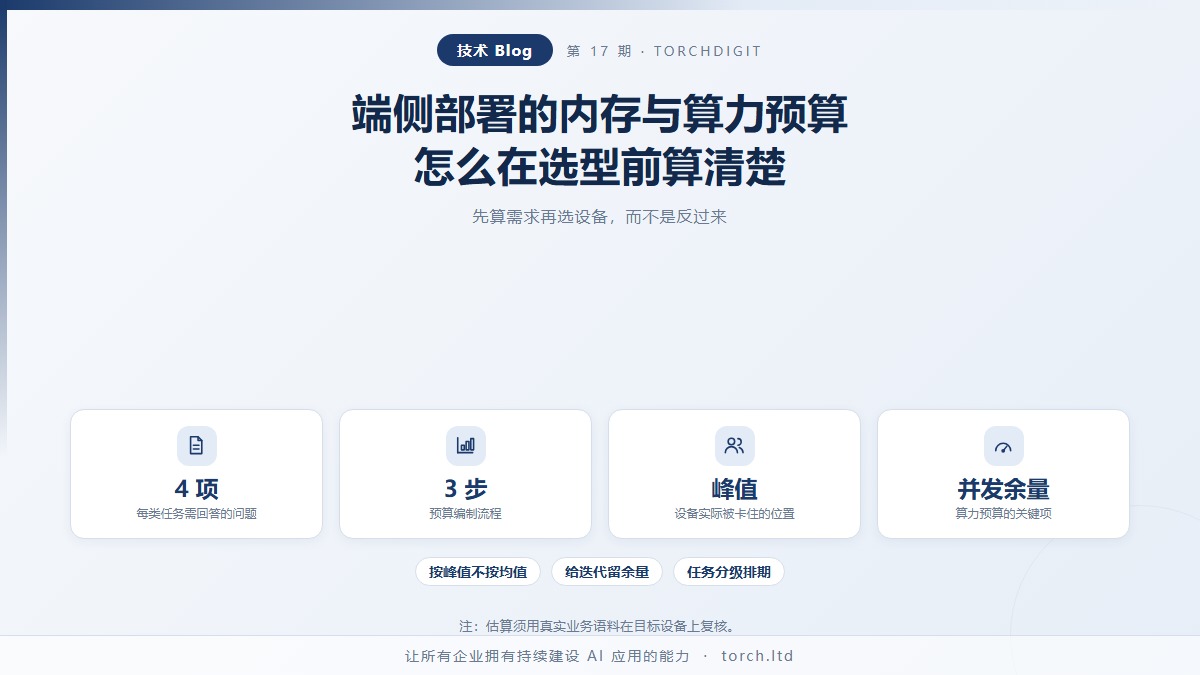
端侧部署的内存与算力预算怎么在选型前算清楚
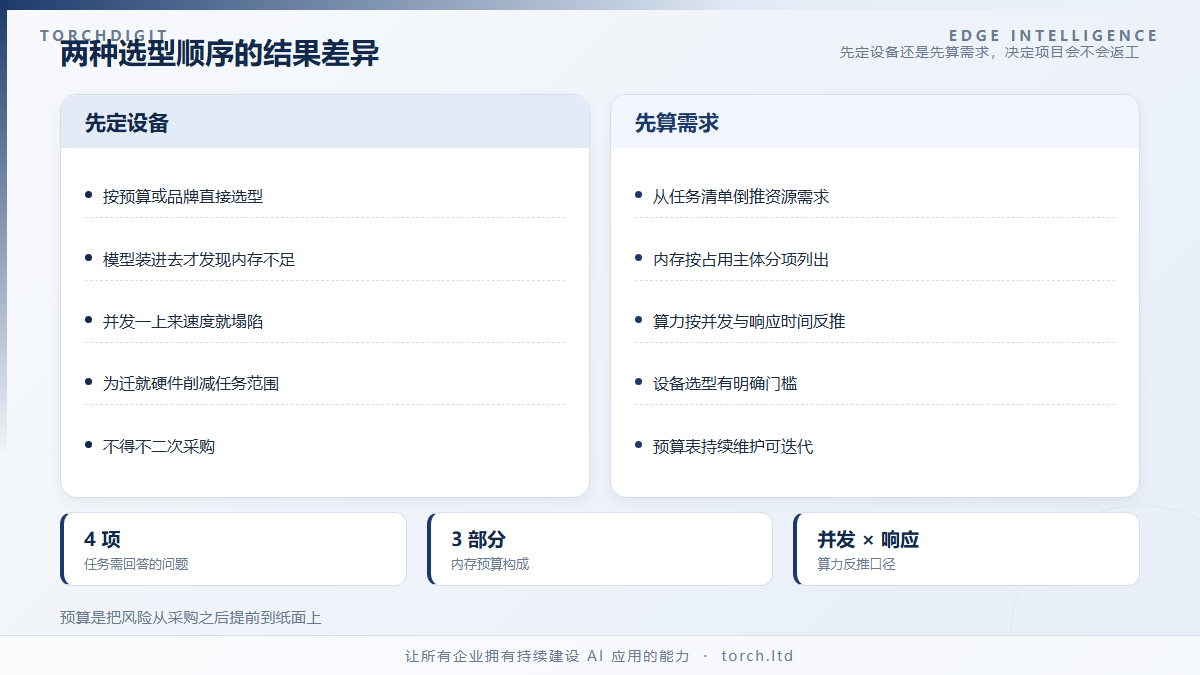
端侧项目的返工,多数发生在选型之后。设备买回来,模型装进去,才发现内存差了两百兆,或者并发一上来速度就掉到不可用。这类问题的根源不在硬件,而在选型顺序——先定了设备再想模型,而不是先算清需求再选设备。把预算算在采购之前,是端侧方案能否一次做对的关键动作。
第一步:从任务清单倒推资源需求
预算的起点不是模型参数,而是任务清单。每类任务需要回答四个问题:单次输入的长度范围、需要的输出长度、单位时间的调用次数、可接受的响应时间。
把这四项列成表,才能得到真实的资源画像。一个只看标题做分类的任务和一个需要通读长文档再回答的任务,对内存和算力的要求可能相差一个数量级,但它们在需求文档里往往都写着「AI 辅助」。
需要特别标注的是峰值场景:月末集中处理、班次交接时段、批量导入之后,调用量往往是均值的数倍。按均值选设备,会在峰值时段集中暴露问题。
第二步:列一张内存预算表
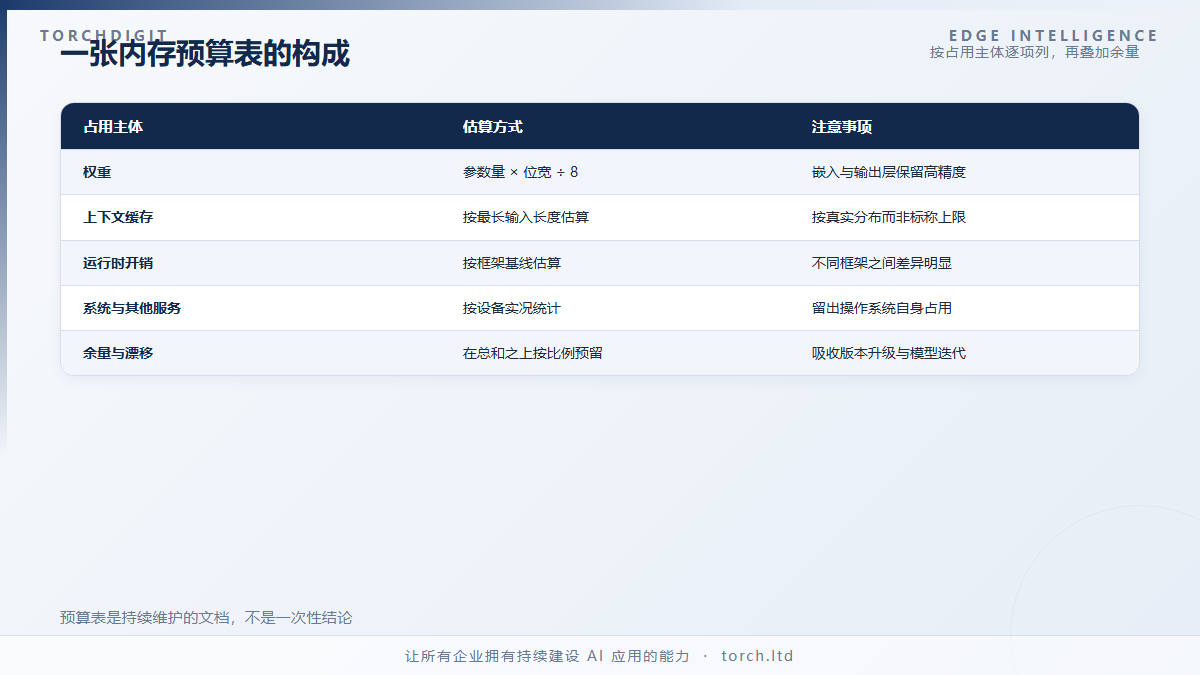
内存预算表按占用主体分项列出,逐项给上限。
权重部分按模型规格与量化位宽估算,1B 参数按 int4 存储约 0.5GB。上下文缓存按最长输入长度估算,并留出压缩或分块的调整空间。运行时开销按框架基线估算。三项相加后,再叠加操作系统与设备上其他服务的占用。
关键是要给峰值留出余量。设备被峰值卡住,而不是被平均值卡住。建议在估算总和之上保留一个明显的余量比例,用于吸收框架版本升级、模型迭代和输入长度增长带来的漂移。
预算表的作用不只是选设备。当内存不够时,它能告诉你是压权重、缩上下文还是换框架,而不是笼统地判断「这台机器不行」。
第三步:算力预算要算并发余量
算力预算常犯的错误是只测单请求速度。单请求下速度达标,不代表多请求下可用。解码阶段的瓶颈在内存带宽,多个请求并发时共享同一条带宽,速度会按并发数摊薄。
正确的算法是:确定单请求可接受的最大响应时间,反推单请求的最低速度,再乘以并发数,得到设备需要提供的总吞吐。如果这个总吞吐超出设备的带宽能力,方案要么降低并发、要么缩短输入、要么提高量化压缩率。
还要把任务分级。并非所有任务都需要同等响应速度,把可等待的任务排到低峰时段或串行执行,能显著降低对设备性能的要求。